


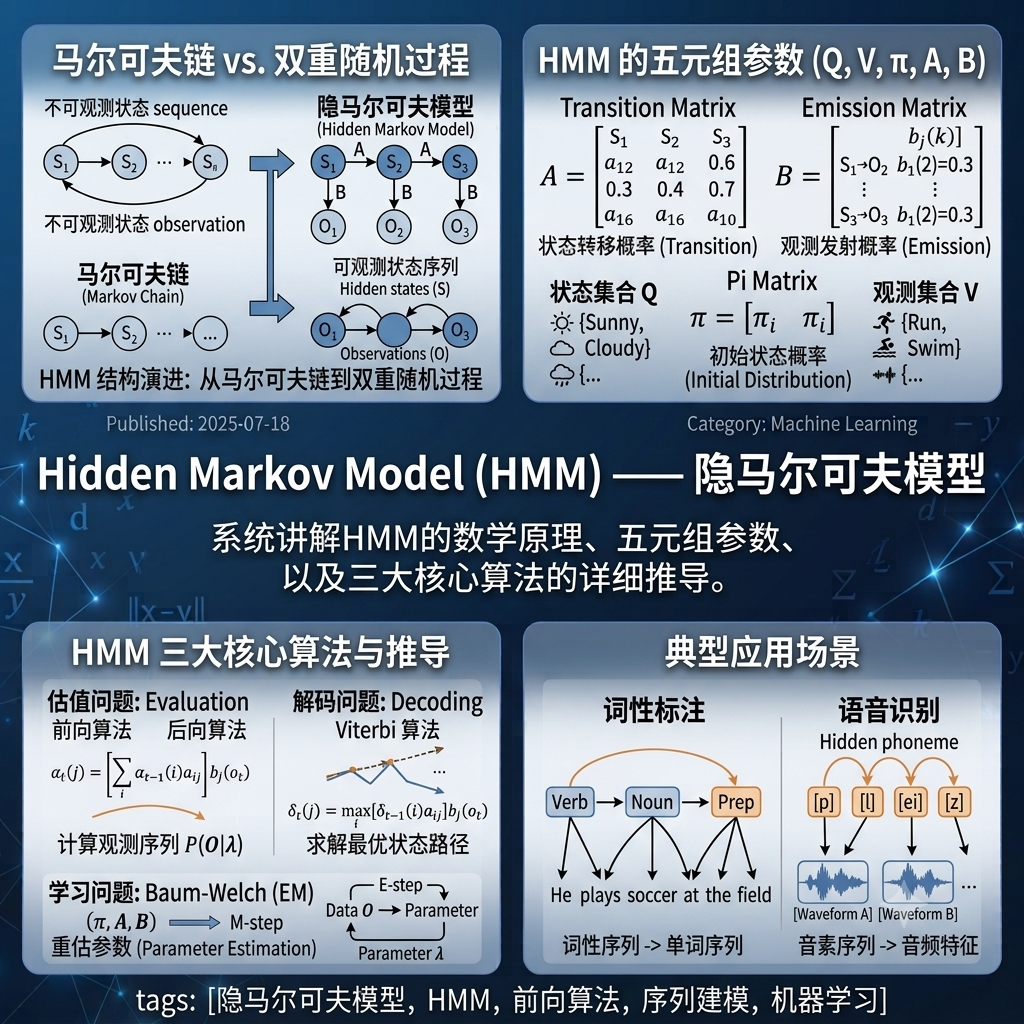
Hidden Markov Model (HMM) —— 隐马尔可夫模型
系统讲解隐马尔可夫模型(HMM)的完整数学原理与三大核心算法:从马尔可夫链到双重随机过程的演进出发,定义HMM的五元组参数(Q, V, π, A, B);详细推导估值问题、解码问题和学习问题;并通过词性标注、语音识别等经典应用场景展示HMM的实践价值。
阅读文章
ZHY's Blog
A UNIVERSE OF IDEAS · BY ZHANG HAOYI
让好奇心 点亮知识宇宙
在代码、模型与思想之间自由漫游。这里持续记录人工智能、机器学习、软件工程与成长实践,让每次阅读都成为一次新的发现。


ARTICLE NOTE
前两篇文章中,我们先后学习了逻辑回归和 KNN。逻辑回归通过梯度下降学习决策边界,KNN 依靠距离度量寻找近邻——它们虽然方法论迥异,但共享同一个本质:都是判别式模型,即直接建模 ,在特征空间里 画一条线(或划定一个区域) 来区分不同类别。
朴素贝叶斯彻底翻转了建模视角。它是一个生成式模型——不直接画边界,而是先学习每个类别下特征是如何分布的(),再结合类别先验 ,通过贝叶斯定理反推出后验概率 。这种“由因推果”的思维方式,赋予了朴素贝叶斯两个独特优势:收敛极快(小样本即可训练)和天然处理缺失值的能力。
当然,这一切都建立在一个极具争议的假设之上——条件独立假设:在给定类别后,所有特征互不影响。这个假设在现实中几乎从不成立,因此被冠以“朴素”(Naive)之名。但讽刺的是,正是这个“错误”的假设,使得模型参数从指数级骤降为线性级,也让朴素贝叶斯在文本分类中成为了经典的 Baseline——因为在高维稀疏的文本数据上,独立性假设的破坏对分类决策的影响远小于预期。
本文将从贝叶斯定理出发,完整推导条件独立假设如何将联合概率分解为条件概率的乘积;深入对比高斯、多项式、伯努利三种分布假设的适用场景——尤其是多项式与伯努利在文本任务中的选择依据;并通过拉普拉斯平滑的数学推导,揭示其如何解决零概率带来的“决策崩溃”问题。最后,我们将从生成式与判别式的根本差异出发,对比朴素贝叶斯与逻辑回归在收敛速度与渐近误差上的权衡。
Note读完本文,你将理解为何一个“错误”的假设能成就一个经典的算法,也将建立起“生成式建模”的底层思维。
下一站我们将进入支持向量机(SVM) ,迎来判别式模型的另一座高峰——它将“几何边界”的思想推向了极致。
贝叶斯定理描述了在已知先验概率和条件概率的情况下,如何计算后验概率:
其中:
在分类任务中,我们只需要比较不同类别的后验概率大小,而 对所有类别都是相同的,因此可以忽略:
现在的问题是:如何计算 ?
如果 有 个特征 ,直接计算联合概率 在现实数据中几乎是不可能的 —— 参数数量会随着特征数量的增加而指数增长。
朴素贝叶斯的核心假设就是在这里发挥作用 —— 在给定类别 的条件下,所有特征之间是相互独立的。
用数学语言表达为:
这个假设将复杂的联合概率分解为 个独立的条件概率的乘积,极大地简化了计算。
结合贝叶斯定理和条件独立假设,朴素贝叶斯的分类决策规则为:
这个公式的含义是:对于给定的样本,计算它在每个类别下的“得分”(先验概率 × 所有特征的条件概率的乘积),选择得分最高的类别作为预测结果。
代码实现:
import numpy as npfrom collections import defaultdict
class NaiveBayesBase: """朴素贝叶斯基类——包含核心的贝叶斯公式框架"""
def __init__(self): self.class_priors = {} # P(y) self.class_feature_probs = {} # P(x_j | y) self.classes = None
def _calculate_priors(self, y): """计算先验概率 P(y)""" n_samples = len(y) for cls in self.classes: self.class_priors[cls] = np.sum(y == cls) / n_samples
def predict(self, X): """预测:选择后验概率最大的类别""" predictions = [] for x in X: scores = {} for cls in self.classes: # log P(y) + sum(log P(x_j | y)) # 使用 log 避免数值下溢 score = np.log(self.class_priors[cls]) for j, x_j in enumerate(x): score += np.log(self._get_feature_prob(cls, j, x_j)) scores[cls] = score predictions.append(max(scores, key=scores.get)) return np.array(predictions)
def _get_feature_prob(self, cls, feature_idx, value): """获取 P(x_j = value | y) —— 子类实现""" raise NotImplementedErrorscikit-learn 提供了三种朴素贝叶斯变体,它们的核心区别在于对特征的条件概率分布 的假设不同。
适用场景:连续型特征,且特征服从(或近似服从)正态分布(高斯分布) 。例如身高、体重、温度、房价等。
数学形式:
对于类别 下的第 个特征,假设其服从正态分布:
其中 和 分别是类别 下第 个特征的均值和方差。
代码实现:
class GaussianNB(NaiveBayesBase): """高斯朴素贝叶斯:假设特征服从正态分布"""
def fit(self, X, y): self.classes = np.unique(y) self.class_priors = {} self.class_stats = {} # {cls: {mean: [...], var: [...]}}
for cls in self.classes: X_cls = X[y == cls] self.class_priors[cls] = len(X_cls) / len(X) self.class_stats[cls] = { 'mean': np.mean(X_cls, axis=0), 'var': np.var(X_cls, axis=0) + 1e-9 # 加小值防止除零 } return self
def _get_feature_prob(self, cls, feature_idx, value): stats = self.class_stats[cls] mu = stats['mean'][feature_idx] sigma2 = stats['var'][feature_idx] # 高斯分布的概率密度函数 coef = 1 / np.sqrt(2 * np.pi * sigma2) exp = np.exp(-(value - mu) ** 2 / (2 * sigma2)) return coef * exp注意:高斯朴素贝叶斯通常不用于文本分类,因为文本特征(词频)不满足正态分布。
适用场景:离散型计数特征,最典型的就是文本分类中的词频(Term Frequency) 。
数学形式:
假设特征 是非负整数(如单词在文档中出现的次数),且服从多项分布:
在实践中,通常忽略前端的系数(因为对所有类别都相同),直接使用:
其中 ,通过频率估计得到。
核心区别:多项式朴素贝叶斯关心的是 “单词出现了多少次”。
代码实现:
class MultinomialNB(NaiveBayesBase): """多项式朴素贝叶斯:适用于计数特征(如词频)"""
def fit(self, X, y, alpha=1.0): """ X: 词频矩阵,shape (n_samples, n_features) alpha: 拉普拉斯平滑参数 """ self.classes = np.unique(y) self.alpha = alpha self.class_priors = {} self.feature_probs = {} # {cls: array of P(feature_j | cls)}
for cls in self.classes: X_cls = X[y == cls] # 先验概率 self.class_priors[cls] = len(X_cls) / len(X) # 计算每个特征在类别 cls 下的总计数 feature_counts = np.sum(X_cls, axis=0) total_counts = np.sum(feature_counts) # 拉普拉斯平滑 self.feature_probs[cls] = (feature_counts + alpha) / (total_counts + alpha * X.shape[1]) return self
def _get_feature_prob(self, cls, feature_idx, value): return self.feature_probs[cls][feature_idx] ** value适用场景:二值特征(0/1,True/False)。在文本分类中,它表示 “某个单词是否在文档中出现”,而不是出现了多少次。
数学形式:
对于每个特征 :
其中 。
核心区别:伯努利朴素贝叶斯关心的是 “单词有没有出现”,而不是出现了几次。
代码实现:
class BernoulliNB(NaiveBayesBase): """伯努利朴素贝叶斯:适用于二值特征(词是否出现)"""
def fit(self, X, y, alpha=1.0): """ X: 二值矩阵,shape (n_samples, n_features),值只能是 0 或 1 """ self.classes = np.unique(y) self.alpha = alpha self.class_priors = {} self.feature_probs = {} # {cls: array of P(feature_j=1 | cls)}
for cls in self.classes: X_cls = X[y == cls] self.class_priors[cls] = len(X_cls) / len(X) # 计算每个特征在类别 cls 下取值为 1 的样本数 ones_count = np.sum(X_cls, axis=0) total = len(X_cls) # 拉普拉斯平滑(二值情况分母加 2) self.feature_probs[cls] = (ones_count + alpha) / (total + 2 * alpha) return self
def _get_feature_prob(self, cls, feature_idx, value): p = self.feature_probs[cls][feature_idx] if value == 1: return p else: return 1 - p三种模型的对比总结
模型 特征类型 特征取值 典型场景 文本分类适用性 GaussianNB 连续型 实数 身高、体重、温度 ❌ 不适用 MultinomialNB 离散计数 非负整数 词频、TF-IDF ✅ 最常用 BernoulliNB 二值 {0, 1} 词是否出现 ✅ 适用(短文本) 选择技巧:
- 对于长文档或需要词频信息的任务 → MultinomialNB
- 对于短文本(如短信、标题),词频信息有限 → BernoulliNB 可能更合适
- 两种都试一下,选择效果更好的
朴素贝叶斯的核心计算涉及概率的连乘:
这里有一个致命的问题:如果任何一个 ,整个乘积就变成 0。这在文本分类中尤其常见。假设训练集中没有出现“机器学习”这个词,但测试集中出现了。那么:
于是,任何包含“机器学习”的文档,被分类为“科技类”的概率都变成了 0 —— 即使其他所有特征都强烈支持“科技类”。
拉普拉斯平滑(Laplace Smoothing) 的核心思想是给每个可能的取值都“预分配”一个小的计数,避免出现零概率。
对于多项式朴素贝叶斯,特征 在类别 下的概率估计为:
其中:
对于伯努利朴素贝叶斯,概率估计为:
其中 是类别 中特征 出现的样本数, 是类别 的样本总数。
拉普拉斯平滑可以理解为在参数上施加了一个均匀先验(Uniform Prior) 。也就是说,我们在看到任何数据之前,先假设所有可能的取值都有相同的初始概率。
随着训练数据量的增加,平滑引入的“先验偏见”会逐渐被数据“淹没”,估计值趋近于真实概率。
代码实现:带平滑的朴素贝叶斯:
from sklearn.feature_extraction.text import CountVectorizerfrom sklearn.naive_bayes import MultinomialNB, BernoulliNBfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import accuracy_score, classification_report
# 示例:垃圾邮件分类corpus = [ "免费领取奖品 点击链接 立即注册", "恭喜您获得一等奖 请联系客服", "明天下午三点开会 请准时参加", "项目进度报告 请查阅附件", "免费 优惠 折扣 限时抢购", "本周五团队建设活动 自愿报名",]labels = [1, 1, 0, 0, 1, 0] # 1: 垃圾邮件, 0: 正常邮件
# 文本向量化(词频)vectorizer = CountVectorizer()X = vectorizer.fit_transform(corpus).toarray()
X_train, X_test, y_train, y_test = train_test_split( X, labels, test_size=0.3, random_state=42)
# 多项式朴素贝叶斯(适合词频)mnb = MultinomialNB(alpha=1.0) # alpha=1 即拉普拉斯平滑mnb.fit(X_train, y_train)print(f"MultinomialNB 准确率: {accuracy_score(y_test, mnb.predict(X_test)):.4f}")
# 伯努利朴素贝叶斯(适合词是否出现)bnb = BernoulliNB(alpha=1.0)bnb.fit(X_train, y_train)print(f"BernoulliNB 准确率: {accuracy_score(y_test, bnb.predict(X_test)):.4f}")关于平滑参数的选择:
alpha=0:无平滑,可能遇到零概率问题alpha=1:标准拉普拉斯平滑alpha > 1:更强的平滑,适合词汇表很大的场景alpha < 1:较弱的平滑机器学习模型可以分为两大类:
| 生成式模型(Generative) | 判别式模型(Discriminative) | |
|---|---|---|
| 建模目标 | 联合分布 | 条件分布 |
| 学习方式 | 先学数据如何生成,再推分类 | 直接学分类边界 |
| 典型代表 | 朴素贝叶斯、HMM、GDA | 逻辑回归、SVM、决策树 |
| 能否生成新样本 | 可以 | 不可以 |
| 对缺失数据的处理 | 更灵活 | 较困难 |
生成式模型的核心是:先建模数据的“生成过程” —— 即特征 和标签 是如何被联合产生的 —— 然后再用贝叶斯定理反推分类。
判别式模型的核心是:直接学习输入到输出的映射,不关心数据是如何生成的。
朴素贝叶斯和逻辑回归构成了一对经典的生成-判别搭档(Generative-Discriminative Pair)。
| 对比维度 | 朴素贝叶斯(生成式) | 逻辑回归(判别式) |
|---|---|---|
| 建模对象 | ||
| 假设强度 | 强(条件独立假设) | 弱(直接建模后验) |
| 收敛速度 | 快——小样本即可 | 慢——需要更多数据 |
| 渐近误差 | 较高 | 较低 |
| 计算复杂度 | 极低 | 中等 |
| 对特征相关性的处理 | 忽略(独立性假设) | 自动学习特征间的关系 |
判别式学习有更低的渐近误差,但生成式分类器可能以更快的速度趋近其(较高的)渐近误差。
这意味着:
尽管条件独立假设在现实中几乎从不成立,朴素贝叶斯在文本分类中依然表现出色。原因如下:
import numpy as npfrom sklearn.feature_extraction.text import CountVectorizer, TfidfVectorizerfrom sklearn.naive_bayes import MultinomialNB, BernoulliNB, GaussianNBfrom sklearn.model_selection import train_test_split, cross_val_scorefrom sklearn.metrics import accuracy_score, f1_score, classification_reportfrom sklearn.datasets import fetch_20newsgroups
# 加载数据:使用 20 Newsgroups 的二分类子集categories = ['rec.sport.baseball', 'sci.space']newsgroups = fetch_20newsgroups(subset='all', categories=categories, shuffle=True, random_state=42)
X = newsgroups.datay = newsgroups.target
# 划分训练集和测试集X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# ============ 使用 CountVectorizer(词频) ============vectorizer = CountVectorizer(max_features=5000, stop_words='english')X_train_count = vectorizer.fit_transform(X_train)X_test_count = vectorizer.transform(X_test)
# 多项式朴素贝叶斯mnb = MultinomialNB(alpha=1.0)mnb.fit(X_train_count, y_train)y_pred_mnb = mnb.predict(X_test_count)print(f"MultinomialNB (词频) 准确率: {accuracy_score(y_test, y_pred_mnb):.4f}")
# 伯努利朴素贝叶斯(需要将计数转为二值)X_train_binary = (X_train_count.toarray() > 0).astype(int)X_test_binary = (X_test_count.toarray() > 0).astype(int)bnb = BernoulliNB(alpha=1.0)bnb.fit(X_train_binary, y_train)y_pred_bnb = bnb.predict(X_test_binary)print(f"BernoulliNB (二值) 准确率: {accuracy_score(y_test, y_pred_bnb):.4f}")
# ============ 使用 TfidfVectorizer(TF-IDF) ============tfidf = TfidfVectorizer(max_features=5000, stop_words='english')X_train_tfidf = tfidf.fit_transform(X_train)X_test_tfidf = tfidf.transform(X_test)
mnb_tfidf = MultinomialNB(alpha=1.0)mnb_tfidf.fit(X_train_tfidf, y_train)y_pred_tfidf = mnb_tfidf.predict(X_test_tfidf)print(f"MultinomialNB (TF-IDF) 准确率: {accuracy_score(y_test, y_pred_tfidf):.4f}")
# ============ 高斯朴素贝叶斯(不适用,仅供对比) ============# 将稀疏矩阵转为密集数组(仅用于演示)X_train_dense = X_train_count.toarray()gnb = GaussianNB()gnb.fit(X_train_dense, y_train)y_pred_gnb = gnb.predict(X_test_count.toarray())print(f"GaussianNB 准确率: {accuracy_score(y_test, y_pred_gnb):.4f}")# 通常 GaussianNB 在文本分类中表现很差总结
概念 核心内容 贝叶斯定理 ,后验 ∝ 似然 × 先验 条件独立假设 ,朴素贝叶斯的“朴素”来源 GaussianNB 适用于连续、正态分布的特征 MultinomialNB 适用于计数特征(词频),文本分类最常用 BernoulliNB 适用于二值特征(词是否出现),适合短文本 拉普拉斯平滑 ,解决零概率问题 生成式 vs 判别式 朴素贝叶斯是生成式(建模 ),逻辑回归是判别式(建模 ) 核心要点回顾
- 朴素贝叶斯的“朴素” 来自条件独立假设——在给定类别的情况下,所有特征相互独立。这个假设几乎从不成立,但极大地简化了计算。
- 三种分布假设对应三种不同的特征类型:
- 高斯:连续值(身高、体重)
- 多项式:计数(词频)
- 伯努利:二值(词是否出现)
- 拉普拉斯平滑解决零概率问题——给每个可能的取值“预分配”一个计数,避免因训练集不完整而导致概率为 0。
- 生成式 vs 判别式:朴素贝叶斯是生成式模型,建模联合分布 ;逻辑回归是判别式模型,直接建模条件分布 。数据量小时朴素贝叶斯收敛更快,数据量大时逻辑回归渐近误差更低。
- 文本分类中的选择:长文档用 MultinomialNB(词频信息重要),短文档用 BernoulliNB(是否出现更重要)。两种都试试,选效果更好的。
按顺序完成这组文章,循序渐进地掌握主题
发现错误、内容过时或有改进想法?欢迎告诉我
根据本文分类与标签,为你推荐可能感兴趣的内容
系统讲解隐马尔可夫模型(HMM)的完整数学原理与三大核心算法:从马尔可夫链到双重随机过程的演进出发,定义HMM的五元组参数(Q, V, π, A, B);详细推导估值问题、解码问题和学习问题;并通过词性标注、语音识别等经典应用场景展示HMM的实践价值。
阅读文章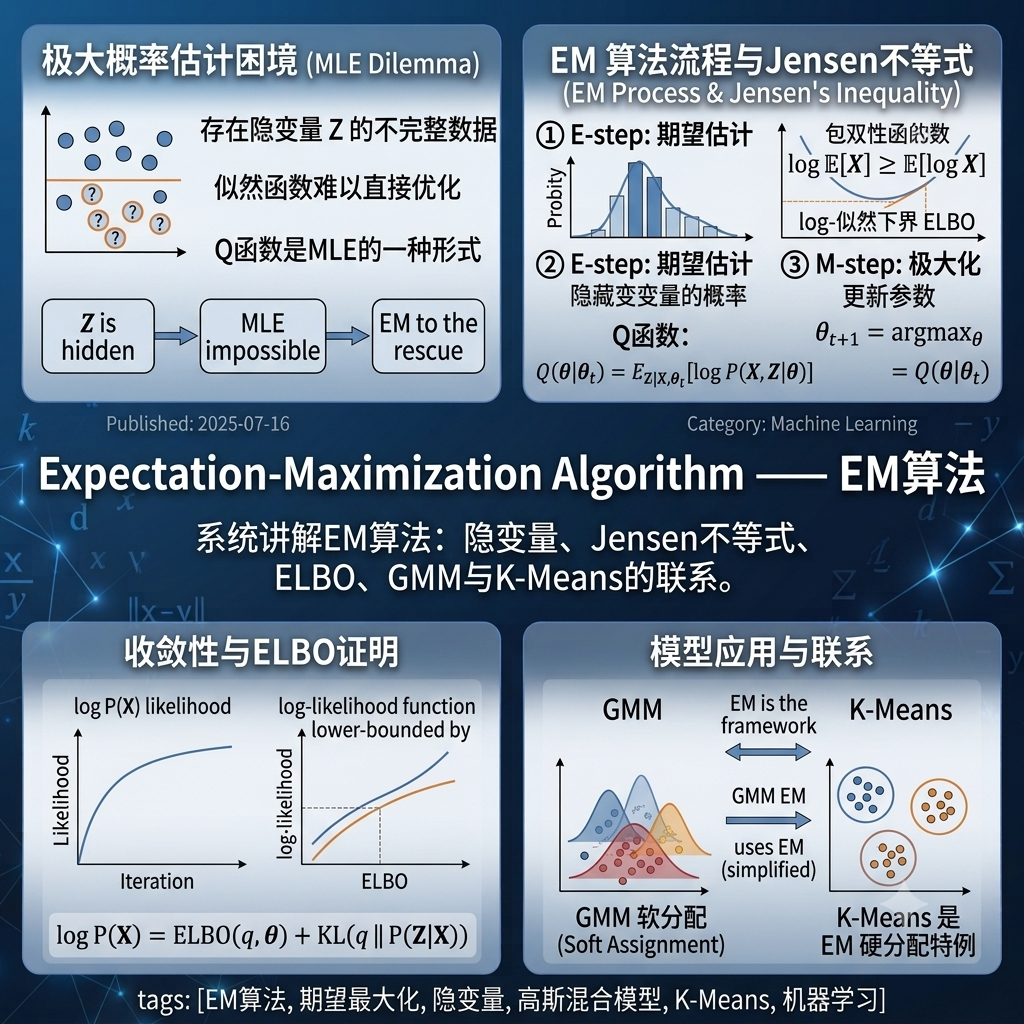
系统讲解期望最大化(EM)算法的完整数学原理:从极大似然估计在隐变量存在时的困境出发,推导E步与M步的迭代框架;基于Jensen不等式证明ELBO证据下界与收敛性;通过二硬币模型与高斯混合模型(GMM)两个完整实例展示EM的具体计算流程;揭示K-Means是EM在硬分配下的特例这一深层联系。
阅读文章
系统讲解K-Means聚类的核心原理与算法细节,涵盖Lloyd交替优化算法的收敛性分析、K-Means作为EM算法特例的理论联系(硬分配 vs 软分配)、K-Means++初始化策略的D²采样机制与O(log K)近似保证,以及肘部法则与轮廓系数的选择K值方法及其局限。
阅读文章请使用微信扫描二维码分享
当前文章会保持在原页面