


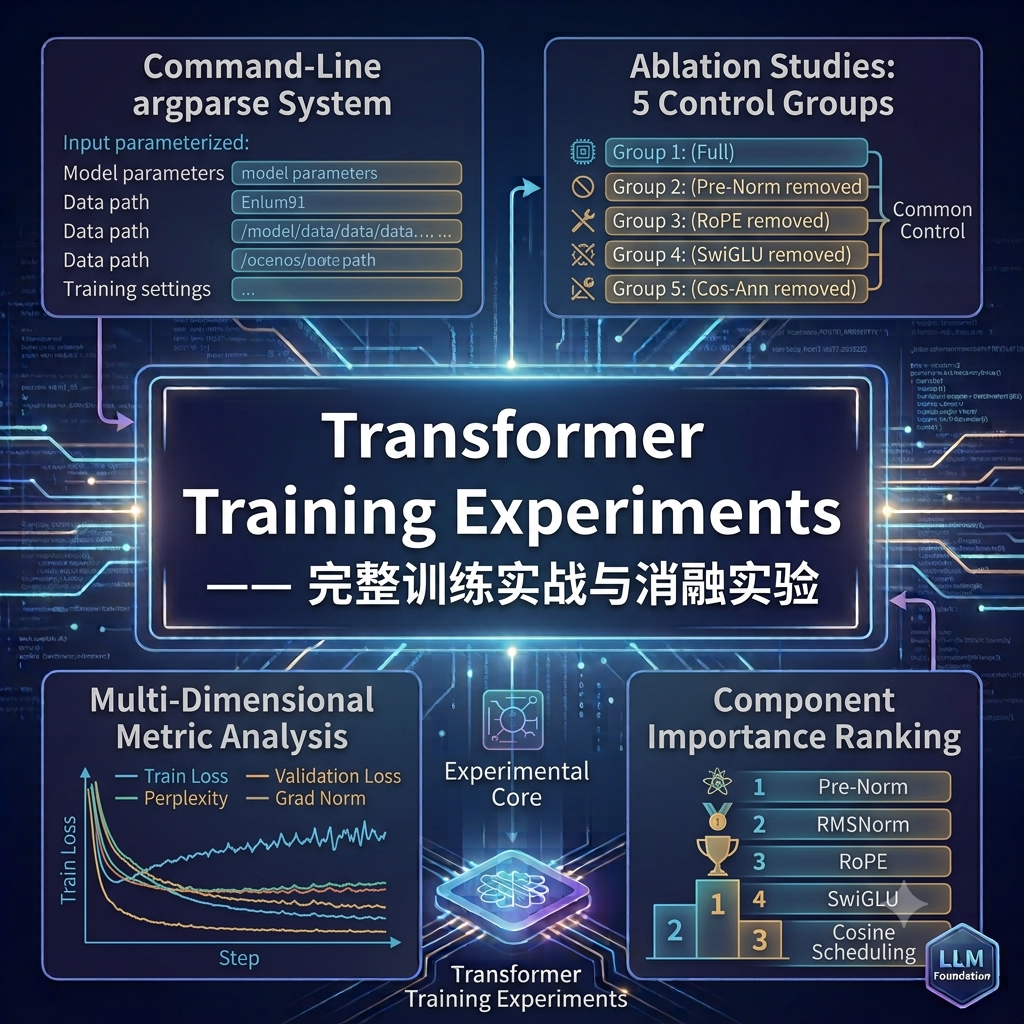
Transformer Training Experiments —— 完整训练实战与消融实验
系统讲解基于argparse的命令行训练脚本设计与五组消融实验的科学验证:从高度参数化的训练框架出发,设计五组对照实验以量化各组件贡献;基于训练损失/验证损失/困惑度/梯度范数等多维度指标分析,得出各组件重要性排序;展示完整的训练循环实现及自动化批量实验的工程价值。附有完整命令行参数体系与实验配置。
阅读文章
ZHY's Blog
A UNIVERSE OF IDEAS · BY ZHANG HAOYI
让好奇心 点亮知识宇宙
在代码、模型与思想之间自由漫游。这里持续记录人工智能、机器学习、软件工程与成长实践,让每次阅读都成为一次新的发现。


ARTICLE NOTE
经过前四篇博客的积累,我们已经完成了从原始文本到完整模型架构的全部构建工作。我们拥有了:
然而,模型本身只是一个空壳——它还没有学习任何知识。要让模型从数据中学习,我们需要一套完整的训练系统。
这篇博客聚焦于训练一个语言模型所需的全部“后勤系统”:
这些组件共同构成了训练循环的基础设施。没有它们,模型只是一堆随机初始化的权重;有了它们,模型才能从数据中汲取知识,逐步变得智能。
语言模型训练的核心任务是给定前文,预测下一个token的概率分布。对于每个位置 ,模型输出一个 vocab_size 维的logits向量 ,经过softmax后得到概率分布 。真实目标 是下一个token的实际ID(一个整数)。
训练的目标是最大化真实token的预测概率,等价于最小化负对数似然。这就是交叉熵损失(Cross-Entropy Loss):
其中 是词汇表大小。
直接按照上述公式计算存在严重的数值问题:e^{z} 可能溢出。标准的解决方案是直接计算 log_softmax,而不是先算 softmax 再取 log。
log_softmax 的数学形式为:
结合“减去最大值”的数值稳定技巧,最终实现为:
inputs_max = torch.max(inputs, dim=-1, keepdim=True)[0]inputs_stable = inputs - inputs_maxlog_sum_exp = torch.logsumexp(inputs_stable, dim=-1, keepdim=True)log_probs = inputs_stable - log_sum_exp这里的 torch.logsumexp 是一个专门设计的函数,它等价于 ,但在内部使用了数值稳定技巧(先减最大值再指数求和再取对数)。
直接计算 log_softmax 更稳定的原因 —— 如果先计算 softmax = exp(x) / sum(exp(x)),再取 log(softmax),则exp(x) 可能溢出(当 较大时);即使不溢出,浮点数精度损失也会累积。而 log_softmax 直接在 log 域操作,利用 log_sum_exp 避免了中间结果的指数爆炸。
得到 log_probs(形状为 [batch_size, vocab_size]) 后,我们需要提取每个样本对应的真实类别(target)的 log 概率:
target_log_probs = log_probs[torch.arange(batch_size), targets]使用整数索引:torch.arange(batch_size) 提供行索引,targets 提供列索引(每个样本的真实类别ID)。
最终损失为负对数概率的平均值:
losses = -target_log_probsreturn losses.mean()在训练循环中,损失函数连接模型输出和反向传播的起点:
logits = model(input_ids) # (B, S, vocab_size)loss = cross_entropy_loss(logits.view(-1, vocab_size), targets.view(-1))loss.backward() # 梯度从这里开始反向传播注意点:此处将 logits 和 targets 都展平了(view(-1, ...)),因为cross_entropy_loss 期望输入为 (batch_size * seq_len, vocab_size) 和 (batch_size * seq_len,)。这等价于将所有位置的损失放在一起计算平均。
在第一篇博客中,我们使用BPE分词器将文本文件转换为token ID序列,并以 .dat文件(二进制格式)存储。转换过程中使用了np.memmap:
token_array = np.array(tokens, dtype=np.uint16)fp = np.memmap(dat_file, dtype=np.uint16, mode='w+', shape=token_array.shape)fp[:] = token_array[:]np.memmap 将磁盘上的文件映射为内存中的数组,不一次性将全部数据加载到内存,而是按需从磁盘读取。这让我们可以处理远超内存容量的超大型数据集。
data_loading 函数从一维token数组中采样一个批次的数据:
def data_loading(dataset, batch_size, context_length, device): data_length = len(dataset) max_start_idx = data_length - context_length - 1
start_indices = np.random.randint(0, max_start_idx + 1, size=(batch_size,)) idx = start_indices[:, None] + np.arange(context_length + 1) tokens = dataset[idx]
inputs = tokens[:, :-1] # 前 context_length 个token targets = tokens[:, 1:] # 后 context_length 个token关键设计点:
1. 随机采样起始位置
对于每个batch中的每个序列,我们随机选择一个起始位置 start_idx,范围从 0 到 data_length - context_length - 1。这确保了每个epoch中,模型看到的数据切片都不同,增加了训练的随机性。
2. 向量化的索引构造
idx = start_indices[:, None] + np.arange(context_length + 1)这里使用了NumPy的广播机制:start_indices 形状为 (batch_size,),np.arange(context_length + 1) 形状为 (context_length + 1,),两者相加得到形状为 (batch_size, context_length + 1) 的索引矩阵,每一行是从对应起始位置开始的连续索引序列。
3. 输入-目标对
对于每个长度为 context_length + 1 的token序列,我们将其分为:
inputs:前 context_length 个token(作为模型的输入)targets:后 context_length 个token(作为预测目标)这意味着位置 的target是位置 的token——模型始终在预测下一个token。
在实际训练中,数据加载是训练循环中的一环:
dataset = np.memmap('data/train.dat', dtype=np.uint16, mode='r')
for step in range(num_steps): inputs, targets = data_loading(dataset, batch_size, context_length, device) logits = model(inputs) loss = cross_entropy_loss(logits, targets) loss.backward() optimizer.step() optimizer.zero_grad()每次调用 data_loading 都会返回新的随机采样批次,这相当于一种在线数据增强,防止模型过拟合于特定的序列片段。
对于验证集,我们通常不进行随机采样,而是按照顺序遍历整个数据集,或者采用固定步长的采样,以确保评估的稳定性。代码中未显式实现验证集的迭代器,实际使用时可以构建类似的函数但使用顺序索引。
SGD(随机梯度下降) 是最基础的迭代更新规则:
[ \theta_t = \theta_{t-1} - \eta \cdot g_t, ]
其中 (g_t = \nabla L(\theta_{t-1})) 是当前损失关于参数的梯度,(\eta) 为学习率。这个简单形式存在三大缺陷:学习率全局固定,难以调优;对不同参数采用同一尺度更新,忽略了各维度上的差异;缺乏惯性,容易在陡峭的谷壁上来回震荡而收敛缓慢。
Momentum 引入一阶动量 (m_t = \beta_1 m_{t-1} + (1-\beta_1) g_t),用梯度的指数移动平均代替瞬时梯度,相当于给更新过程增加了“惯性”,从而加速收敛并减轻震荡。
RMSProp 则提出二阶动量 (v_t = \beta_2 v_{t-1} + (1-\beta_2) g_t^2),用梯度平方的移动平均来归一化更新步长,为每个参数赋予自适应学习率。
Adam 将两者结合 —— 同时维护一阶动量(方向)和二阶动量(尺度),其原始更新可写为
[ m_t = \beta_1 m_{t-1} + (1-\beta_1) g_t,\quad v_t = \beta_2 v_{t-1} + (1-\beta_2) g_t^2, ]
[ \theta_t = \theta_{t-1} - \eta \cdot \frac{m_t}{\sqrt{v_t} + \epsilon}. ]
该公式既保留了动量带来的加速效果,又通过 (\sqrt{v_t}) 实现了参数自适应的步长缩放。
AdamW 是 Adam 的一个改进版本,由 Loshchilov 和 Hutter 在 2017 年提出。它与 Adam 的核心区别在于权重衰减(weight decay) 的实现方式。
在原始 Adam 中,若直接在梯度上添加 L2 正则化项,即
[ g_t = \nabla L(\theta_{t-1}) + \lambda \theta_{t-1}, ]
然后将 (g_t) 代入 Adam 更新,则权重衰减项会被 (\sqrt{v_t}) 除,导致不同参数的实际衰减速率不一致,大大削弱了正则化的效果。
AdamW 的核心思想是将权重衰减从梯度中解耦,更新流程如下:
合并后即为
[ \theta_t = \theta_{t-1} - \eta \left( \frac{\hat{m}_t}{\sqrt{\hat{v}t} + \epsilon} + \lambda \theta{t-1} \right). ]
这里的权重衰减项 (\lambda \theta_{t-1}) 不受自适应学习率 (\sqrt{\hat{v}_t}) 的影响,因而每个参数都以相同的速率 (\eta \lambda) 向零衰减,保持了 L2 正则化的本意。
数学上,若不考虑动量和二阶矩,该更新退化为标准的带权重衰减的 SGD;而 Adam 的实现则会在正则项上额外乘以 (\eta / (\sqrt{v_t}+\epsilon)),破坏了尺度一致性。
在代码层面,这两步通常写作:
# Adam 更新(不含权重衰减)p.data.addcdiv_(m, denom, value=-step_size)# 解耦的权重衰减(AdamW核心创新)p.data.add_(p.data, alpha=-group['weight_decay'] * group['lr'])训练初期,(m_t) 和 (v_t) 的初值均为零。展开一阶动量递推式:
[ m_t = (1-\beta_1)\sum_{i=1}^t \beta_1^{,t-i} g_i. ]
因为 (\sum_{i=1}^t \beta_1^{,t-i} = \frac{1-\beta_1^t}{1-\beta_1}),若梯度序列平稳(约为常数 (g)),则
[ \mathbb{E}[m_t] = (1-\beta_1)\sum_{i=1}^t \beta_1^{,t-i} g = (1-\beta_1^t) g \neq g. ]
可见 (m_t) 的期望被缩小了约 ((1-\beta_1^t)) 倍,直接使用 (m_t) 会导致初期更新步长严重偏小。类似地,(v_t) 也存在同样的偏差。
Adam 采用除偏校正:
[ \hat{m}_t = \frac{m_t}{1-\beta_1^t},\quad \hat{v}_t = \frac{v_t}{1-\beta_2^t}. ]
此时 (\mathbb{E}[\hat{m}_t] = g),(\mathbb{E}[\hat{v}_t] = g^2)(在平稳假设下),校正后的估计是无偏的。
在代码中体现为:
bias_correction1 = 1 - beta1 ** state['step']bias_correction2 = 1 - beta2 ** state['step']step_size = group['lr'] / bias_correction1denom = v.sqrt().div_(bias_correction2 ** 0.5).add_(group['eps'])当 (t) 很小时,(1-\beta_1^t) 数值小,step_size 被放大,补偿了初始偏差;随着 (t) 增大,校正因子趋近于 1,偏差校正的影响逐渐消失。
如果缺少这一偏差矫正,则模型在最初几步会更新过慢,严重浪费训练资源。
lr(学习率):通常为 (10^{-5}) 到 (10^{-3}),取决于模型参数量与数据集规模。beta1(一阶动量衰减率):常用 0.9,控制历史梯度的记忆时长。beta2(二阶动量衰减率):原始 Adam 中为 0.999,但现代大模型(如 Llama)常用 0.95。较小的 beta2 使二阶矩估计更“灵敏”,更快响应梯度的近期变化,对大规模训练有利。eps(防止除零):(10^{-8}) 左右,避免数值不稳定。weight_decay(正则化强度):通常在 0.01 到 0.1 之间,取决于模型正则化需求。学习率是控制更新步长的核心超参数。
最优策略通常是动态调整:训练初期用较小学习率使模型稳定起步(预热),中期保持较高学习率以快速探索,后期逐步衰减以精细拟合局部最优点。
初始时模型权重随机,梯度往往具有较大的范数和方差。若直接使用大学习率,一步更新就可能将参数推向高损失区域,导致梯度爆炸或训练崩溃。
预热阶段采用线性增长策略:
[ \eta_{\text{warmup}}(t) = \eta_{\max} \cdot \frac{t}{T_{\text{warm}}},\quad 0 \le t \le T_{\text{warm}}. ]
代码实现为:
if it < warmup_iters: return max_lr * it / warmup_iters该公式将学习率从 0 平滑提升至 (\eta_{\max})。在预热期间,模型逐渐获得较为稳定的梯度方向,之后再进入正常训练。实践中,预热步数通常占总步数的 1%~5%。例如当总步数 100,000 时,预热 2,000 步。
预热结束后,学习率按余弦曲线从峰值 (\eta_{\max}) 衰减至谷值 (\eta_{\min}):
[ \eta(t) = \eta_{\min} + \frac{\eta_{\max} - \eta_{\min}}{2} \left(1 + \cos\left(\pi \cdot \frac{t - T_{\text{warm}}}{T_{\text{total}} - T_{\text{warm}}}\right)\right). ]
代码实现为:
progress = (it - warmup_iters) / (cosine_cycle_iters - warmup_iters)cosine = (1 + math.cos(math.pi * progress)) / 2return min_lr + (max_lr - min_lr) * cosine令 (p = \frac{t - T_{\text{warm}}}{T_{\text{total}} - T_{\text{warm}}}),当 (p) 从 0 到 1 时,(\cos(\pi p)) 从 1 单调递减至 -1,因此 (\eta) 从 (\eta_{\max}) 平滑降至 (\eta_{\min})。该函数的导数连续且单调,不会引起学习率的突变,避免了阶梯式衰减中模型受惊导致的性能退化。
余弦退火的有效性 —— 在训练前期((p) 较小),(\eta) 接近最大值,梯度更新步长大,有助于模型快速穿越平坦区域;在中后期,学习率缓慢降低,更新步长缩小,使模型在损失函数的局部最小值附近进行精细搜索。相比线性衰减,余弦衰减在后期下降更平缓,给予模型更多时间进行微调,因而经常获得更好的最终泛化性能。
在训练循环中,优化器与调度器协同工作——每个 step 后更新优化器内部的 lr 字段:
optimizer = AdamW(model.parameters(), lr=max_lr, ...)
for step in range(total_steps): # 前向传播、损失计算、反向传播 ... optimizer.step() optimizer.zero_grad()
# 计算当前学习率 lr = cosine_schedule(step, max_lr, min_lr, warmup_iters, total_steps) for param_group in optimizer.param_groups: param_group['lr'] = lr每次调度后,优化器在下一轮 step() 中会使用新的学习率进行参数更新。这种设计使得学习率变化与更新过程完全解耦,便于灵活调整调度策略,而无需改动优化器本身。
在深层网络中,梯度在反向传播过程中可能呈指数级增长(尤其在训练的早期阶段)。梯度爆炸会导致参数更新步长过大,模型发散;梯度值超出浮点数表示范围,变为 NaN,训练崩溃
梯度裁剪(Gradient Clipping) 是一种简单有效的应对策略:当梯度的全局范数超过预设阈值时,按比例缩放所有梯度,使范数回到阈值以内。
代码中实现了基于全局L2范数的裁剪:
def gradient_clipping(parameters, max_l2_norm, epsilon=1e-6): grads = [p.grad for p in parameters if p.grad is not None] if not grads: return
grad_l2 = torch.norm(torch.cat([grad.flatten() for grad in grads]), 2)
if grad_l2 > max_l2_norm: clip = max_l2_norm / (grad_l2 + epsilon) for grad in grads: grad.mul_(clip)具体步骤:
max_l2_norm,计算裁剪系数 clip = max_l2_norm / grad_l2clip,使全局范数正好等于 max_l2_norm使用全局范数而不是逐层裁剪的原因 —— 全局范数保留了不同层之间的相对梯度尺度。逐层裁剪可能破坏这种平衡,导致模型的学习动态变得不稳定。
max_l2_norm 的典型取值为 0.5 到 5.0 之间。较大的模型通常使用较小的阈值。在 GPT-2 原始实现中,梯度裁剪阈值为 1.0。
裁剪阈值不应设置得过小,否则会限制模型的学习能力;也不应设置得过大,否则起不到防止爆炸的作用。实践中,可以监测训练初期梯度范数的分布,将阈值设为典型范数值的 2-3 倍。
将所有组件组合成完整的训练循环:
# 1. 加载数据train_data = np.memmap('data/train.dat', dtype=np.uint16, mode='r')val_data = np.memmap('data/valid.dat', dtype=np.uint16, mode='r')
# 2. 初始化模型model = TransformerLM(vocab_size=18017, context_length=1024, d_model=768, n_layers=12, n_heads=12, d_ff=3072, theta=10000.0)model.to(device)
# 3. 初始化优化器optimizer = AdamW(model.parameters(), lr=3e-4, betas=(0.9, 0.95), eps=1e-8, weight_decay=0.1)
# 4. 训练循环total_steps = 100000warmup_steps = 2000max_lr = 3e-4min_lr = 3e-5
for step in range(total_steps): # 4a. 数据加载 inputs, targets = data_loading(train_data, batch_size=64, context_length=1024, device=device)
# 4b. 前向传播 logits = model(inputs) loss = cross_entropy_loss(logits.view(-1, vocab_size), targets.view(-1))
# 4c. 反向传播 loss.backward()
# 4d. 梯度裁剪 gradient_clipping(model.parameters(), max_l2_norm=1.0)
# 4e. 优化器更新 optimizer.step() optimizer.zero_grad()
# 4f. 更新学习率 lr = cosine_schedule(step, max_lr, min_lr, warmup_steps, total_steps) for param_group in optimizer.param_groups: param_group['lr'] = lr
# 4g. 日志记录 if step % 100 == 0: print(f"Step {step}: loss={loss.item():.4f}, lr={lr:.6f}")这个循环涵盖了训练所需的所有关键环节,从数据到模型再到优化,形成了一个完整的信息流闭环。
总结本篇博客完成了语言模型训练系统的构建,涵盖了从数据到优化的完整链路:
- 交叉熵损失:实现了数值稳定的 log_softmax,利用 log-sum-exp 技巧避免溢出,并提取目标类别的负对数似然。
- 数据加载器:使用
np.memmap高效处理大规模数据集,通过随机采样和向量化索引实现批次数据的快速生成。- AdamW 优化器:从零实现了自适应学习率优化算法,重点揭示了偏差校正的必要性和权重衰减解耦的核心创新。
- 余弦学习率调度:设计了两阶段调度策略——预热阶段线性增长,余弦阶段平滑衰减,平衡了训练初期的稳定性和后期的精细调优。
- 梯度裁剪:基于全局 L2 范数的裁剪方法,作为防止梯度爆炸的可靠保障。
至此,我们已具备了训练一个语言模型所需的全部组件。后续我们将进入训练的实战环节——从参数初始化到监控训练过程,完整走一遍模型从随机到“智能”的蜕变过程。
按顺序完成这组文章,循序渐进地掌握主题
发现错误、内容过时或有改进想法?欢迎告诉我
根据本文分类与标签,为你推荐可能感兴趣的内容
系统讲解基于argparse的命令行训练脚本设计与五组消融实验的科学验证:从高度参数化的训练框架出发,设计五组对照实验以量化各组件贡献;基于训练损失/验证损失/困惑度/梯度范数等多维度指标分析,得出各组件重要性排序;展示完整的训练循环实现及自动化批量实验的工程价值。附有完整命令行参数体系与实验配置。
阅读文章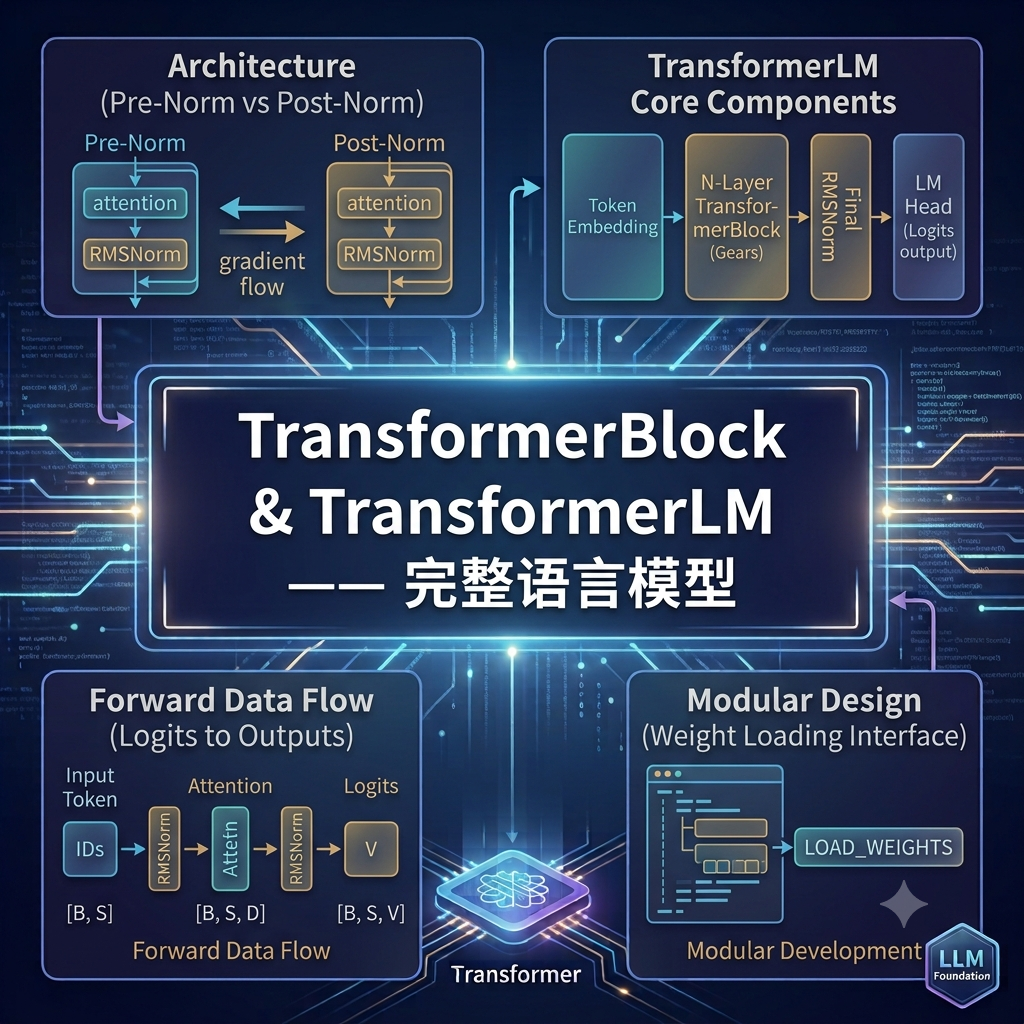
系统讲解如何将Transformer的各个组件组合成完整的可训练语言模型:从TransformerBlock的Pre-Norm与Post-Norm架构对比入手,剖析残差连接如何保障深层网络梯度流动;深入模块化设计中的权重加载接口;拆解TransformerLM四大核心组件(Token Embedding → N层TransformerBlock → Final RMSNorm → LM Head)及其超参数设计的权衡考量;完整跟踪从token ID到logits的前向传播数据流(形状变换全程)。
阅读文章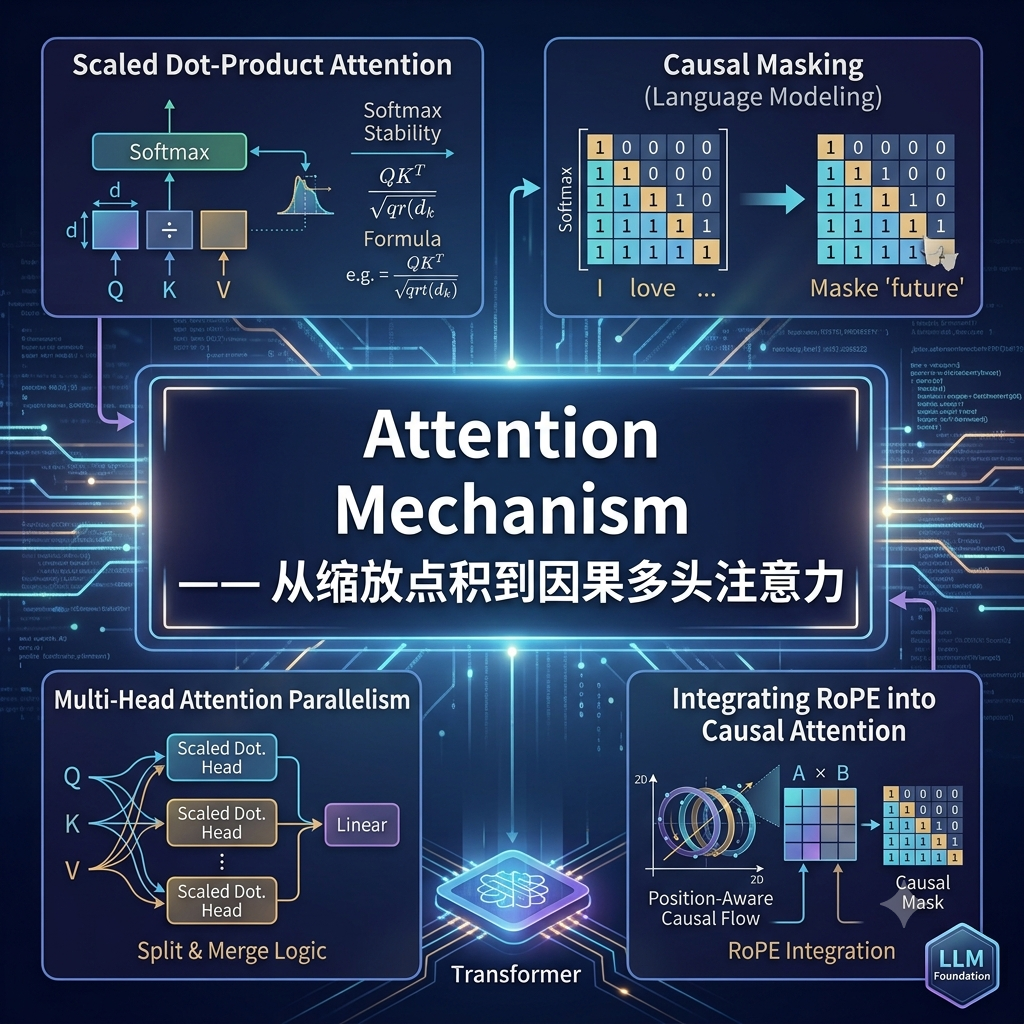
系统讲解Transformer注意力机制的核心原理与完整实现:从数值稳定的Softmax出发,推导缩放点积注意力的数学公式与几何意义;深入剖析因果掩码的下三角矩阵机制及其在自回归语言模型中的关键作用;详解多头注意力的拆分与合并逻辑及并行计算优势;最后阐述RoPE旋转位置编码如何直接融入注意力计算,与因果掩码协同实现带位置感知的因果注意力。
阅读文章请使用微信扫描二维码分享
当前文章会保持在原页面