


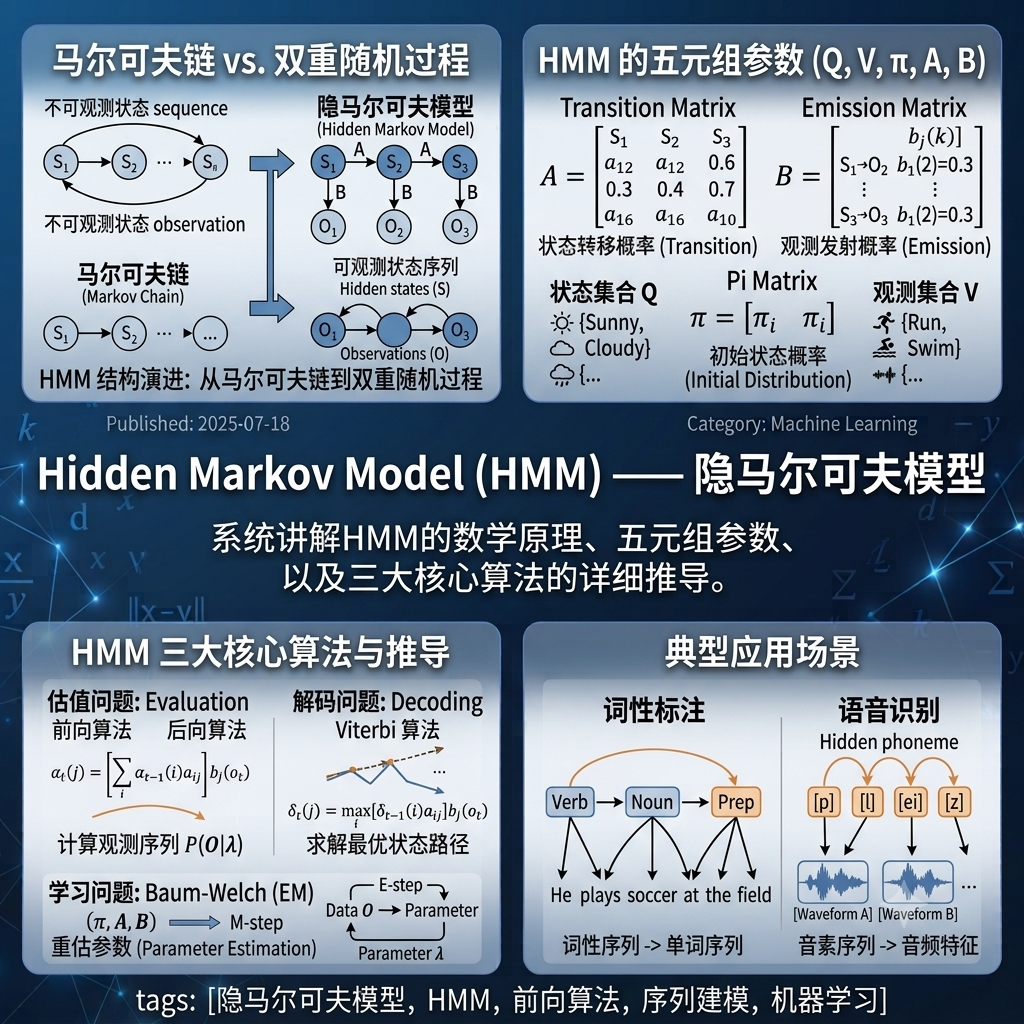
Hidden Markov Model (HMM) —— 隐马尔可夫模型
系统讲解隐马尔可夫模型(HMM)的完整数学原理与三大核心算法:从马尔可夫链到双重随机过程的演进出发,定义HMM的五元组参数(Q, V, π, A, B);详细推导估值问题、解码问题和学习问题;并通过词性标注、语音识别等经典应用场景展示HMM的实践价值。
阅读文章
ZHY's Blog
A UNIVERSE OF IDEAS · BY ZHANG HAOYI
让好奇心 点亮知识宇宙
在代码、模型与思想之间自由漫游。这里持续记录人工智能、机器学习、软件工程与成长实践,让每次阅读都成为一次新的发现。


ARTICLE NOTE
在前两篇文章中,我们先后学习了线性回归和逻辑回归。它们都属于参数化模型——训练阶段通过优化算法(最小二乘或梯度下降)从数据中“提炼”出一组固定的参数 ,预测时只需要 一次计算即可完成。这是一种“急切学习”(Eager Learning)的范式:训练很费力,但预测极快。
K-近邻(KNN) 彻底颠覆了这套流程。它是机器学习中最著名的“懒惰学习”(Lazy Learning)算法 —— 训练阶段几乎不做任何计算,仅仅把训练数据存储下来;预测阶段才“临时抱佛脚”,现场计算新样本与所有训练样本的距离,挑选最近的 个邻居来投票或平均。这种“延迟计算”的策略让 KNN 成为非参数化模型的典型代表:它不对数据分布做任何假设,模型的“容量”随着训练集规模自然增长。
本文将从 KNN 的核心机制出发——分类用投票、回归用平均(或距离加权平均) —— 并深入探讨两个工程落地的关键问题:其一是如何加速,我们将剖析 KD-Tree 与 Ball-Tree 的空间划分原理,理解为何前者在低维高效、后者在高维更有优势;其二是为何在高维会失效,我们将从数学上揭示维度灾难导致欧氏距离趋同的本质原因,并强调特征标准化对 KNN 来说不是可选项而是必选项。
Note读完本文,你将理解“没有训练过程的训练”为何依然有效,也将认清 KNN 的适用边界——它最适合低维、样本量适中的场景。
本文之后,我们将进入朴素贝叶斯,迎来第一个基于概率公式而非距离度量的分类器,开启完全不同的建模视角。
KNN 算法的核心思想是:给定一个测试样本,在训练集中找出与它距离最近的 个样本(即 个邻居),然后根据这些邻居的信息来做预测。
KNN 算法的具体流程为:对每个待预测的样本点,首先计算它与训练集中所有样本点的距离,并按距离从小到大排序;然后选取距离最小的 k 个点,最后根据这 k 个点的标签做决策。
对于分类问题,KNN 使用投票法(Voting) —— 统计 个邻居中每个类别出现的次数,将出现次数最多的类别作为预测结果。
数学上,测试样本 的预测类别为:
其中 是 的 个最近邻的集合, 是指示函数。
K 值的选择至关重要:
对于回归问题,KNN 使用平均法(Averaging) —— 计算 个邻居的输出值的平均值作为预测结果:
但更精细的做法是加权平均 —— 距离越近的邻居权重越大:
其中权重 通常取距离的倒数:。
代码实现:
import numpy as npfrom collections import Counterfrom sklearn.datasets import make_classification, make_regressionfrom sklearn.model_selection import train_test_splitfrom sklearn.preprocessing import StandardScalerfrom sklearn.metrics import accuracy_score, mean_squared_error
class KNN: """从头实现 K-近邻算法(支持分类与回归)"""
def __init__(self, k=5, weights='uniform'): """ k: 邻居数量 weights: 'uniform' 等权投票/平均, 'distance' 距离加权 """ self.k = k self.weights = weights self.X_train = None self.y_train = None
def fit(self, X, y): """KNN 是懒惰学习——训练阶段只存储数据""" self.X_train = X self.y_train = y return self
def _predict_one(self, x): """预测单个样本""" # 计算到所有训练样本的欧氏距离 distances = np.linalg.norm(self.X_train - x, axis=1)
# 获取 k 个最近邻的索引 k_indices = np.argsort(distances)[:self.k] k_distances = distances[k_indices] k_labels = self.y_train[k_indices]
# 判断是分类还是回归 if self.y_train.dtype == np.float64 or self.y_train.dtype == np.float32: # 回归:平均或加权平均 if self.weights == 'uniform': return np.mean(k_labels) else: # 距离加权(加一个小 epsilon 防止除零) weights = 1.0 / (k_distances + 1e-8) return np.average(k_labels, weights=weights) else: # 分类:投票或加权投票 if self.weights == 'uniform': counter = Counter(k_labels) return counter.most_common(1)[0][0] else: # 距离加权投票 weights = 1.0 / (k_distances + 1e-8) weight_dict = {} for label, w in zip(k_labels, weights): weight_dict[label] = weight_dict.get(label, 0) + w return max(weight_dict, key=weight_dict.get)
def predict(self, X): return np.array([self._predict_one(x) for x in X])
# ============ 分类示例 ============X_clf, y_clf = make_classification(n_samples=300, n_features=4, n_informative=3, n_redundant=1, n_classes=3, random_state=42)X_train, X_test, y_train, y_test = train_test_split(X_clf, y_clf, test_size=0.3)
# 标准化(后面会解释为什么这是必须的)scaler = StandardScaler()X_train_scaled = scaler.fit_transform(X_train)X_test_scaled = scaler.transform(X_test)
knn = KNN(k=5, weights='distance')knn.fit(X_train_scaled, y_train)y_pred = knn.predict(X_test_scaled)print(f"分类准确率: {accuracy_score(y_test, y_pred):.4f}")
# ============ 回归示例 ============X_reg, y_reg = make_regression(n_samples=300, n_features=4, noise=10, random_state=42)X_train, X_test, y_train, y_test = train_test_split(X_reg, y_reg, test_size=0.3)
scaler = StandardScaler()X_train_scaled = scaler.fit_transform(X_train)X_test_scaled = scaler.transform(X_test)
knn_reg = KNN(k=5, weights='distance')knn_reg.fit(X_train_scaled, y_train)y_pred = knn_reg.predict(X_test_scaled)print(f"回归 MSE: {mean_squared_error(y_test, y_pred):.4f}")KNN 的核心操作是计算距离。最常用的是欧氏距离(Euclidean Distance):
其中 是特征的维度。
除此之外,曼哈顿距离、切比雪夫距离、马氏距离等也各有适用场景。
| 距离名称 | 数学公式 | 直观别名 | 适用场景 | 缺点 / 预处理要求 |
|---|---|---|---|---|
| 欧氏距离 | 直线距离(两点间最短路径) | 特征相互独立、物理含义一致(如图像像素、点云坐标) | 对量纲和异常值极其敏感,必须做标准化 | |
| 曼哈顿距离 | 城市街区距离(只能走直角) | 高维稀疏数据(如文本词频)、特征间有显著异常值 | 比欧氏距离鲁棒,但仍依赖标准化 | |
| 切比雪夫距离 | 棋盘距离(国王走一步的覆盖范围) | 只关心“最坏情况”下的最大偏差(如仓库调度、多指标监控) | 忽略其余维度信息,容易丢失全局相似度 | |
| 马氏距离 | 消除相关性的距离(将椭圆拉伸为正圆) | 特征单位不同(如年龄+收入)、特征间强相关(如身高+体重) | 无需手动标准化,但需计算协方差矩阵逆, 时不可用;计算成本高 |
最朴素的 KNN 实现是暴力法(Brute Force) :对每个待预测样本,计算它与所有训练样本的距离,然后排序取前 个。
这种方法的时间复杂度是 ,其中 是训练样本的数量。当数据集很大时(比如百万级样本),每次预测都要计算百万次距离,这是不可接受的。
KD-Tree(K-Dimensional Tree) 是一种二叉树数据结构,它通过递归地将空间划分为超矩形(Hyper-rectangles) 来组织数据点。
构建过程:
搜索过程:
KD-Tree 的优势:它不需要计算目标点到所有样本的距离,而是通过剪枝跳过了大量不可能成为最近邻的区域。
KD-Tree 的局限性:随着维度 的增加,KD-Tree 的性能会急剧下降。当维度较高时(通常认为 ),KD-Tree 的效率会退化到接近暴力法。这是因为在高维空间中,数据点变得极其稀疏,超矩形之间的边界模糊,剪枝效果大打折扣。
Ball-Tree 是对 KD-Tree 的改进,它使用超球体(Hyperspheres) 而不是超矩形来划分空间。
构建过程:
搜索过程与 KD-Tree 类似,但剪枝条件变为:如果目标点到某个球心的距离减去该球的半径,仍然大于当前找到的最佳距离,则整个球体都可以被剪枝。
Ball-Tree 的优势:
KD-Tree vs Ball-Tree 总结
特性 KD-Tree Ball-Tree 划分形状 超矩形 超球体 低维表现 优秀 良好 高维表现(D>20) 显著下降 相对较好 适用场景 低维到中维数据 高维数据、非均匀分布
代码实现:
from sklearn.neighbors import KNeighborsClassifierimport time
# 生成不同维度的数据for dim in [2, 5, 10, 20, 50]: X, y = make_classification(n_samples=5000, n_features=dim, n_informative=dim, n_redundant=0, n_classes=2, random_state=42) X_train, X_test = X[:4000], X[4000:] y_train, y_test = y[:4000], y[4000:]
# KD-Tree start = time.time() knn_kd = KNeighborsClassifier(n_neighbors=5, algorithm='kd_tree') knn_kd.fit(X_train, y_train) knn_kd.predict(X_test) kd_time = time.time() - start
# Ball-Tree start = time.time() knn_ball = KNeighborsClassifier(n_neighbors=5, algorithm='ball_tree') knn_ball.fit(X_train, y_train) knn_ball.predict(X_test) ball_time = time.time() - start
print(f"维度 {dim:2d}: KD-Tree {kd_time:.4f}s, Ball-Tree {ball_time:.4f}s")# 输出会显示:低维时 KD-Tree 更快,高维时 Ball-Tree 优势明显维度灾难(Curse of Dimensionality) 是指随着特征维度的增加,数据在高维空间中的性质会发生根本性的变化,导致许多在低维空间有效的算法在高维空间中失效。
对于 KNN 来说,维度灾难的影响尤为致命。
在低维空间中(如二维平面),我们的直觉是每个点都有一些“近”的点和一些“远”的点,“最近邻”的概念是有意义的。但在高维空间中,情况完全不同。在高维空间中,所有点到查询点的距离几乎都相等。
我们可以用数学来理解这个现象。假设数据点均匀分布在一个 维单位超立方体 中。对于一个查询点(比如在原点),一个随机数据点到查询点的距离平方为:
由于 ,,。因此:
距离的标准差与期望之比为:
关键结论:随着维度 增大,距离的相对标准差趋于 0。这意味着在高维空间中,所有点到查询点的距离几乎都相等。当所有距离都差不多时,“最近邻”与“最远邻”的区分度消失了。KNN 赖以生存的“邻居”概念变得毫无意义。
样本需求的指数级增长:为了在高维空间中保持同样的样本密度,所需的样本数量随维度指数增长。例如:如果在一维空间中需要 10 个样本才能覆盖一个区间,那么在 10 维空间中就需要 个样本才能达到同样的密度。
搜索效率的崩溃:如前面所述,KD-Tree 在高维空间中效率急剧下降。即使使用 Ball-Tree,也只是“缓解”而非“解决”这个问题。
距离度量的选择:在高维特征空间中,使用曼哈顿距离(L1 范数) 比欧氏距离(L2 范数)更能抵抗维度灾难的影响。这是因为 L1 范数对各个维度的“贡献”是线性的,而 L2 范数是平方的,会进一步放大维度增加带来的效应。
代码实现:
import numpy as npimport matplotlib.pyplot as plt
def demonstrate_curse_of_dimensionality(): """演示高维空间中距离分布的趋同现象""" np.random.seed(42) dimensions = [1, 2, 5, 10, 20, 50, 100]
fig, axes = plt.subplots(2, 4, figsize=(16, 8)) axes = axes.flatten()
for idx, D in enumerate(dimensions): # 在 D 维单位超立方体中生成 1000 个点 points = np.random.rand(1000, D) # 查询点在原点 query = np.zeros(D) # 计算所有点到原点的距离 distances = np.linalg.norm(points - query, axis=1)
axes[idx].hist(distances, bins=30, alpha=0.7) axes[idx].set_title(f'D={D}') axes[idx].set_xlabel('Distance') axes[idx].set_ylabel('Frequency') # 标注均值和标准差 mean_d = np.mean(distances) std_d = np.std(distances) axes[idx].axvline(mean_d, color='red', linestyle='--', label=f'μ={mean_d:.2f}') axes[idx].axvline(mean_d - std_d, color='green', linestyle=':') axes[idx].axvline(mean_d + std_d, color='green', linestyle=':') axes[idx].legend()
plt.suptitle('高维空间中距离分布的趋同现象(维度灾难)', fontsize=14) plt.tight_layout() plt.show() # 观察:随着维度增加,距离分布越来越集中(标准差相对于均值越来越小)
demonstrate_curse_of_dimensionality()KNN 是基于距离的算法。如果不同特征的量纲不同,那么取值范围大的特征会主导距离计算,而取值范围小的特征几乎不起作用。
例如,假设我们要预测房价,有两个特征 —— 房屋面积(50-500 平方米)和卧室数量(1-5 间)。如果直接用原始数据计算欧氏距离,面积特征(范围 450)的差异会完全淹没卧室数量(范围 4)的差异。一个面积相差 100 平方米的房子,和卧室数量相差 2 间的房子,在距离计算中前者会被视为“更远” —— 但这可能完全不符合实际。
标准化(Standardization) :
将数据转换为均值为 0、标准差为 1 的分布。
归一化(Normalization) :
将数据缩放到 [0, 1] 区间。
对于 KNN,标准化通常是更好的选择,因为:
代码示例:
from sklearn.datasets import make_classificationfrom sklearn.model_selection import train_test_splitfrom sklearn.neighbors import KNeighborsClassifierfrom sklearn.preprocessing import StandardScalerfrom sklearn.metrics import accuracy_score
# 生成具有不同量纲特征的数据np.random.seed(42)X, y = make_classification(n_samples=500, n_features=2, n_informative=2, n_redundant=0, n_clusters_per_class=1, random_state=42)# 人为制造量纲差异:第一个特征放大100倍X[:, 0] = X[:, 0] * 100
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3)
# 不做标准化knn_raw = KNeighborsClassifier(n_neighbors=5)knn_raw.fit(X_train, y_train)acc_raw = accuracy_score(y_test, knn_raw.predict(X_test))
# 做标准化scaler = StandardScaler()X_train_scaled = scaler.fit_transform(X_train)X_test_scaled = scaler.transform(X_test)knn_scaled = KNeighborsClassifier(n_neighbors=5)knn_scaled.fit(X_train_scaled, y_train)acc_scaled = accuracy_score(y_test, knn_scaled.predict(X_test_scaled))
print(f"未标准化准确率: {acc_raw:.4f}")print(f"标准化后准确率: {acc_scaled:.4f}")# 标准化后的准确率通常显著高于未标准化的版本总结
概念 核心内容 KNN 分类 投票法: 个邻居中多数类别作为预测 KNN 回归 平均法或加权平均法(权重为距离倒数) KD-Tree 基于超矩形的空间划分,低维高效,高维退化 Ball-Tree 基于超球体的空间划分,高维表现优于 KD-Tree 维度灾难 高维空间中所有距离趋于相等,欧氏距离失效 特征标准化 将各特征缩放到同一量纲,对 KNN 是必须的 核心要点回顾
- KNN 的本质:KNN 是最经典的“懒惰学习”算法,训练阶段只存储数据,预测阶段才进行计算。分类用投票,回归用平均(或加权平均)。
- KD-Tree 与 Ball-Tree:两者都是通过空间划分来加速 KNN 搜索的数据结构。KD-Tree 用超矩形划分,在低维(D<20)时表现优异;Ball-Tree 用超球体划分,在高维和分布不均匀的数据上更有优势。
- 维度灾难的数学本质:在高维空间中,所有点到查询点的欧氏距离几乎相等。“最近邻”与“最远邻”失去区分度,KNN 的预测能力被严重削弱。要维持同样的预测精度,样本数量需要随维度指数增长。
- 特征标准化是必修课:KNN 基于距离,量纲不同的特征会扭曲距离计算。标准化(将每个特征转为均值为 0、标准差为 1)是使用 KNN 前的必要预处理步骤。
- KNN 的适用场景:KNN 简单直观、无需训练、对异常值不敏感,适合低维、样本量适中的数据集。在高维场景下,建议先做降维(如 PCA)或考虑使用其他算法。
按顺序完成这组文章,循序渐进地掌握主题
发现错误、内容过时或有改进想法?欢迎告诉我
根据本文分类与标签,为你推荐可能感兴趣的内容
系统讲解隐马尔可夫模型(HMM)的完整数学原理与三大核心算法:从马尔可夫链到双重随机过程的演进出发,定义HMM的五元组参数(Q, V, π, A, B);详细推导估值问题、解码问题和学习问题;并通过词性标注、语音识别等经典应用场景展示HMM的实践价值。
阅读文章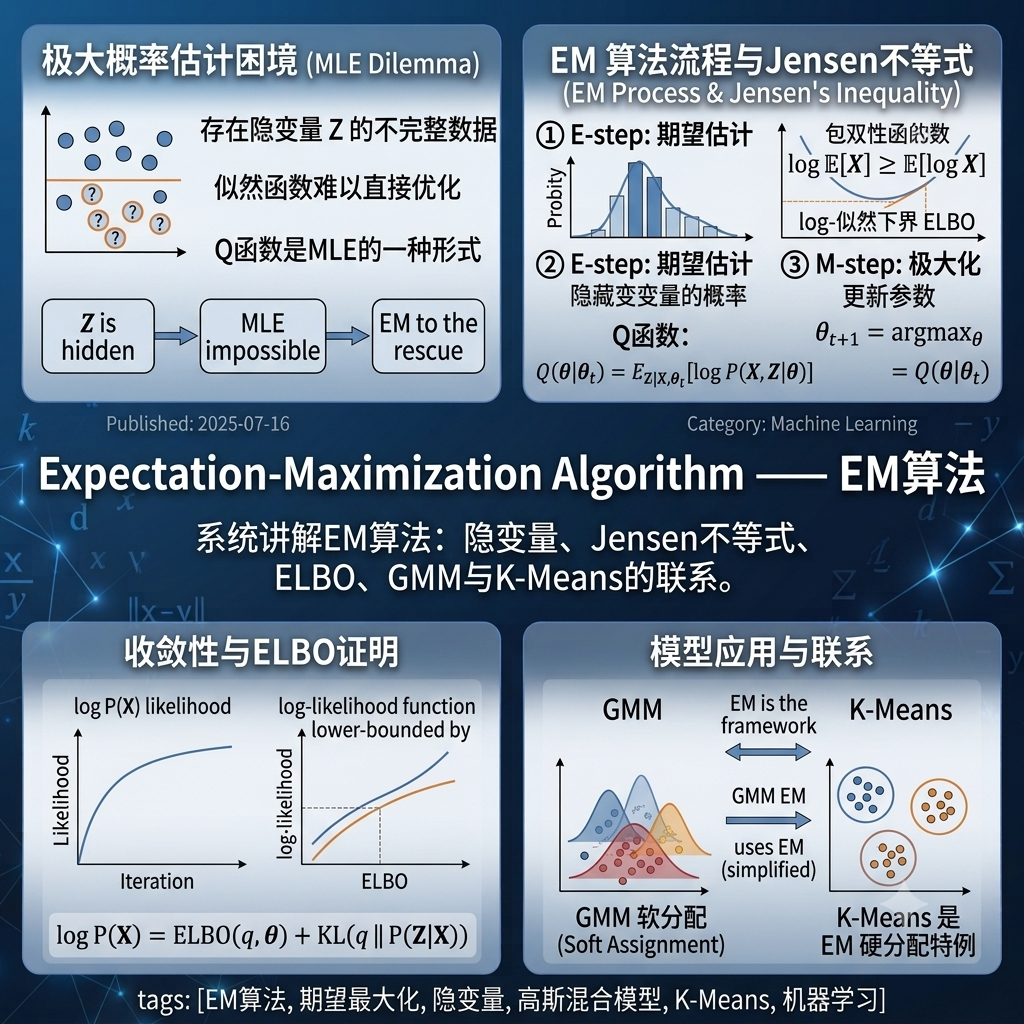
系统讲解期望最大化(EM)算法的完整数学原理:从极大似然估计在隐变量存在时的困境出发,推导E步与M步的迭代框架;基于Jensen不等式证明ELBO证据下界与收敛性;通过二硬币模型与高斯混合模型(GMM)两个完整实例展示EM的具体计算流程;揭示K-Means是EM在硬分配下的特例这一深层联系。
阅读文章
系统讲解K-Means聚类的核心原理与算法细节,涵盖Lloyd交替优化算法的收敛性分析、K-Means作为EM算法特例的理论联系(硬分配 vs 软分配)、K-Means++初始化策略的D²采样机制与O(log K)近似保证,以及肘部法则与轮廓系数的选择K值方法及其局限。
阅读文章请使用微信扫描二维码分享
当前文章会保持在原页面