


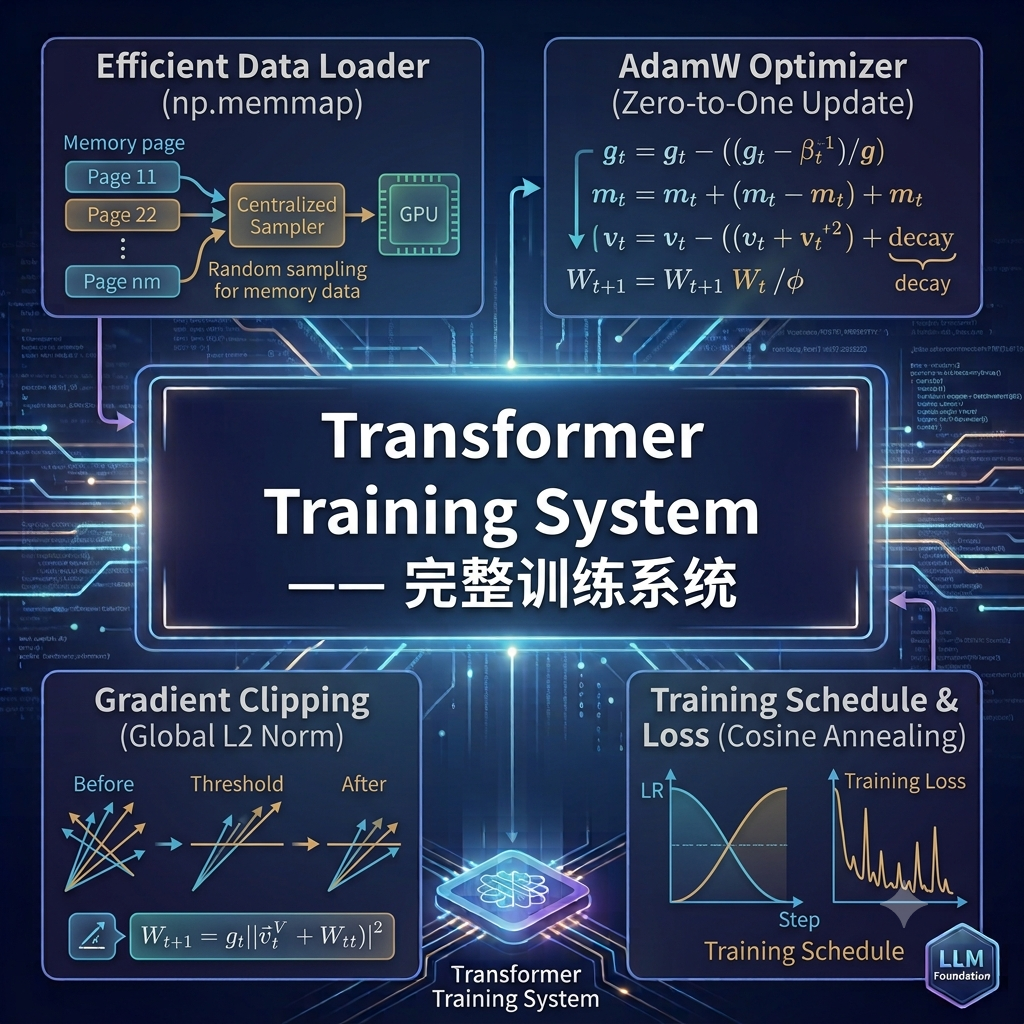
Transformer Training System —— 完整训练系统
系统讲解语言模型训练的核心系统组件:从数值稳定的交叉熵损失出发,剖析基于np.memmap的高效数据加载器与随机采样批次生成逻辑;从零推导AdamW优化器的完整更新公式;设计余弦退火学习率调度器;实现基于全局L2范数的梯度裁剪以防止梯度爆炸。完整展示从数据到优化器的训练闭环。
阅读文章
ZHY's Blog
A UNIVERSE OF IDEAS · BY ZHANG HAOYI
让好奇心 点亮知识宇宙
在代码、模型与思想之间自由漫游。这里持续记录人工智能、机器学习、软件工程与成长实践,让每次阅读都成为一次新的发现。


ARTICLE NOTE
经过前五篇博客的积累,我们已经完成了从分词、基础算子、注意力机制、模型组装到训练系统的全部构建工作。现在,我们将进入最终阶段 —— 实际训练模型,并通过严谨的消融实验验证每一项设计决策的科学性。
在深度学习研究中,消融实验(Ablation Study) 是评估不同组件贡献度的黄金标准。它的核心思想是通过系统地移除或替换模型中的某个组件,观察性能变化,从而量化该组件的重要性。这不仅帮助我们验证理论假设,更能指导我们在资源有限的情况下做出最优的设计取舍。
本文将围绕一个完整的训练框架展开,涵盖:
训练大语言模型涉及大量超参数 —— 模型架构(层数、维度、头数)、训练配置(批次大小、步数)、优化器参数(学习率、衰减率)、数据路径等等。将这些参数硬编码在脚本中会导致代码僵化,无法进行系统性的消融实验。
我们的训练脚本U_Trainer.py采用命令行参数(argparse) 的方式,将所有可调参数暴露为命令行选项,使得我们可以通过简单的shell脚本或命令行轻松切换不同配置,实现自动化的批量实验。
整个参数体系可划分为五大类别,每类对应训练中的一个关键决策维度:
模型架构参数(决定模型容量与结构):
--d_model:模型宽度,典型值512~768--num_layers:模型深度,典型值4~12--num_heads:注意力头数,需满足d_model % num_heads == 0--d_ff:前馈网络隐藏维度,SwiGLU下约8/3*d_model,SiLU下约4*d_model--context_len:最大序列长度,影响内存和计算复杂度消融实验开关(设计决策的“阀门”):
--use_rmsnorm / --no_rmsnorm:是否启用RMSNorm--norm_position:pre或post,控制归一化位置--use_rope / --no_rope:是否使用RoPE位置编码--use_swiglu / --use_silu:切换SwiGLU或FFNSiLU这些开关的设计使得我们可以在不修改任何模型代码的前提下,通过命令行参数快速生成不同的模型变体。
优化器参数(控制学习动态):
--max_lr、--min_lr:学习率上下界--warm_up_it、--cosine_it:预热步数和余弦周期--weight_decay:AdamW的权重衰减系数--betas、--eps:Adam的超参数训练与数据参数:
--batch_size:批处理大小--train_steps:训练循环轮数--val_interval、--val_batches--data_dir:数据路径,指向预处理好的.dat文件基础设施参数:
--device:自动选择CPU/CUDA/MPS--wandb_project:实验追踪与可视化--is_base_experiment:标记是否为基础实验(控制检查点保存行为)这种高度参数化的设计使得我们可以一次性运行所有消融实验,而无需多次修改源码,极大地提高了实验效率。
在训练脚本中,get_experiment_name函数根据消融配置自动生成具有描述性的实验名称:
norm_str = "rmsnorm" if args.use_rmsnorm else "no_rmsnorm"pos_str = f"{args.norm_position}_norm"rope_str = "rope" if args.use_rope else "nope"ffn_str = "swiglu" if args.use_swiglu else "silu"return f"{norm_str}-{pos_str}-{rope_str}-{ffn_str}"例如,完整基线模型的实验名为rmsnorm-pre_norm-rope-swiglu,而无RoPE的消融实验名为rmsnorm-pre_norm-nope-swiglu。这种命名方式使得实验结果一目了然,便于后续分析和可视化。
对于基础模型(--is_base_experiment),脚本会在checkpoints/下创建以实验名命名的子目录,保存检查点、配置文件(config.json)和实验摘要(summary.json);而消融实验默认不保存检查点,只记录wandb日志和生成图表,以节省存储空间。
训练循环是模型学习的核心引擎。代码实现遵循了现代LLM训练的标准流程,并加入了丰富的监控与恢复机制。
在main()函数的训练循环中,每一步都严格按照“前向-损失-反向-裁剪-优化-调度-日志”的顺序执行,关键代码如下:
for iter_num in range(start_iter, args.train_steps): # 1. 更新学习率(余弦调度) lr = cosine_schedule(iter_num, max_lr, min_lr, warm_up_it, cosine_it) for param_group in optimizer.param_groups: param_group['lr'] = lr
# 2. 加载批次数据 input_ids, target_ids = data_loading(train_data, batch_size, context_len, device) input_ids = input_ids.long().to(device) target_ids = target_ids.long().to(device)
# 3. 前向传播与损失计算 optimizer.zero_grad() logits = model(input_ids) loss = cross_entropy_loss(logits.view(-1, vocab_size), target_ids.view(-1))
# 4. 反向传播 loss.backward()
# 5. 梯度裁剪(防止爆炸) gradient_clipping(model.parameters(), args.clip_grad_norm) grad_norm = compute_gradient_norm(model) # 监控用
# 6. 优化器更新 optimizer.step()
# 7. 记录与验证 # ...与很多框架在optimizer.step()外部修改学习率不同,我们在每次迭代开始时根据当前步数计算学习率,然后直接修改优化器参数组中的lr值。
这种做法确保了调度器与优化器状态完全同步,并且支持从检查点恢复时继续正确的调度(因为调度器是基于迭代次数计算的,而非基于存储的lr值)。
余弦调度函数cosine_schedule 实现了三段式策略:预热(线性增长)→ 余弦衰减(平滑下降)→ 保持最小学习率。这种设计已被GPT-3、Llama等模型验证为高效稳定。
计算梯度范数(compute_gradient_norm) 不仅用于裁剪判断,更是一个重要的训练健康指标。
在训练过程中记录梯度范数的变化趋势,如果发现范数持续异常增大(比如超过阈值数倍),说明模型可能处于不稳定的学习状态,此时需要调整学习率或检查数据质量。
梯度裁剪的阈值--clip_grad_norm默认为1.0,这个值在GPT-2论文中被采用,并在实践中被证明适用于多种规模的模型。裁剪操作原地缩放所有梯度,保证了后续优化器更新所使用的梯度范数不超过阈值。
验证逻辑封装在validate_model函数中,它在验证集上运行若干个批次(--val_batches,默认10个),计算平均损失和困惑度(Perplexity)。验证不进行梯度计算(torch.no_grad()),且模型被设置为eval模式,以确保验证过程的确定性。
检查点保存仅针对基础实验(--is_base_experiment),且具备以下特点:
--save_intervals步(默认1000)保存一个带有步数标记的检查点best_model.ptcheckpoint_final.pt所有检查点包含模型状态字典、优化器状态字典和当前迭代次数,这使得断点续训(--resume_ckp)成为可能。
我们使用tqdm创建进度条,实时显示当前损失、平均损失、困惑度和学习率。同时,所有关键指标(训练损失、验证损失、困惑度、梯度范数、学习率等)通过wandb记录,便于后期可视化与对比分析。
消融实验的目的是量化每个设计决策对模型性能的贡献。我们设计了五组实验,其中一组为基线(完整模型),其余四组分别移除或替换一个关键组件。
所有实验共享相同的超参数基准:
d_model=512, num_layers=4, num_heads=16, context_len=256batch_size=32, train_steps=5000max_lr=1e-3, min_lr=1e-4, warmup=500, cosine=10000, weight_decay=1e-2, beta1=0.9, beta2=0.95, eps=1e-8max_l2_norm=1.0| 实验编号 | 名称 | RMSNorm | 归一化位置 | RoPE | FFN类型 |
|---|---|---|---|---|---|
| 1 | Baseline | ✅ (RMSNorm) | Pre-Norm | ✅ | SwiGLU |
| 2 | No RMSNorm | ❌ (恒等映射) | Pre-Norm | ✅ | SwiGLU |
| 3 | Post-Norm | ✅ (RMSNorm) | Post-Norm | ✅ | SwiGLU |
| 4 | No RoPE | ✅ (RMSNorm) | Pre-Norm | ❌(无位置编码) | SwiGLU |
| 5 | SiLU代替SwiGLU | ✅ (RMSNorm) | Pre-Norm | ✅ | FFNSiLU (2个权重) |
在实验5中,为保持参数量可比,我们设置 d_ff=4*d_model=2048(而SwiGLU实验中使用 d_ff=8/3*d_model≈1365,实际取1344以保证能被64整除)。这样两种FFN的参数量大致相同。
基于消融实验的可视化图表(figures/ablation_experiment_charts/),完整覆盖5组消融曲线(01_base_model-红色[Baseline]、02_ablation_no_rmsnorm-黄色、03_ablation_post_norm-绿色、04_ablation_no_rope-蓝色、05_ablation_silu-紫色),逐项结合每一张图、每一条曲线走势对比Baseline完成深度分析。
两张训练损失图表分别为原始逐步波动损失train/loss与平滑平均损失train/avg_loss,曲线趋势完全同步,平滑图可消除噪声直观对比收敛速度与最终收敛值。
 图1:train/loss(原始波动训练损失)
本图为未平滑的原始逐步损失,曲线外围浅色阴影代表单步损失波动区间,可直观观察各组训练稳定性:
 图2:train/avg_loss(平滑训练损失)
困惑度为语言建模核心评价指标,数值越低代表模型文本预测精度越高;两张图表分别为原始波动train/perplexity与平滑train/avg_perplexity,趋势对应损失曲线。
 图3:train/perplexity(原始波动训练困惑度)
浅色阴影代表单步困惑度波动区间,用于判断预测稳定性:
 图4:train/avg_perplexity(平滑训练困惑度)
梯度范数直接反映反向传播梯度流稳定性,数值越高、波动越大代表梯度爆炸/震荡风险越高,是判断训练稳定性的核心中间指标。
 图5:train/gradient_norm(训练梯度范数)
 图6:train/learning_rate(训练学习率调度)
本图为全部5组消融实验共用的学习率调度策略,5条曲线完全重合,不存在学习率调度差异:
验证集指标用于评估模型泛化能力,曲线差距相比训练集会进一步放大,可清晰区分各组件对泛化性能的影响程度。
 图7:val/loss(验证损失)
 图8:val/perplexity(验证困惑度)
验证困惑度与验证损失趋势完全同步,数值差距进一步放大,直观体现泛化预测精度:
各组综合性能排序(从最优至最差)—— 01_base_model(Baseline) > 05_ablation_silu > 03_ablation_post_norm > 04_ablation_no_rope > 02_ablation_no_rmsnorm
结论
- 归一化相关设计(RMSNorm、Pre-Norm)是深层语言模型训练稳定、泛化能力达标的核心基础,缺失或替换后会造成不可逆的性能衰退;
- RoPE位置编码保障模型时序建模能力,尤其对长文本未知样本的泛化预测精度至关重要;
- SwiGLU门控激活属于小幅增益优化,在算力、参数量受限场景下,可权衡性能损失替换为轻量化SiLU激活;
- 全部消融实验学习率调度完全统一,各组性能差异完全来自模型内部组件设计,排除了学习率带来的实验干扰,消融实验结论具备严谨有效性。
通过命令行参数和实验命名机制,我们可以编写脚本一次性运行所有消融实验,并将结果自动记录到wandb的不同项目中。例如:
# Baselinepython cs336_basics/U_Trainer.py --data_dir ./data --is_base_experiment --experiment_name baseline
# No RMSNormpython cs336_basics/U_Trainer.py --data_dir ./data --no_rmsnorm --experiment_name no_rmsnorm
# Post-Normpython cs336_basics/U_Trainer.py --data_dir ./data --norm_position post --experiment_name post_norm
# No RoPEpython cs336_basics/U_Trainer.py --data_dir ./data --no_rope --experiment_name no_rope
# SiLUpython cs336_basics/U_Trainer.py --data_dir ./data --use_silu --d_ff 2048 --experiment_name silu所有实验配置(包括每个开关的状态)都被记录在wandb配置和本地config.json文件中。每个检查点都包含了模型架构和优化器状态,确保了完全的可复现性——任何人都可以通过相同的命令行参数和检查点,复现出完全相同的结果。
除了数值指标,我们还可以使用 T_Generate_text.py 脚本对训练好的模型进行定性评估。通过给定提示词(如“Once upon a time”),观察模型生成的文本质量,辅助验证消融实验的结论。
总结本篇博客将系列的前五篇成果汇聚于一个统一的实验框架,通过严谨的消融实验,用数据回答了“哪些设计选择真正重要”这一核心问题。我们不仅学会如何训练一个模型,更学会了如何科学地评估设计决策。
核心收获如下:
- 训练框架:一个高度参数化的命令行工具,支持模型配置、消融开关、优化器超参数、数据加载、验证、检查点保存和wandb日志的全流程。
- 实验方法:通过基线对照和系统性地移除/替换组件,量化每个设计点的贡献。
- 实验结论:在现代LLM架构中,归一化层及其位置是最关键的设计因素,位置编码次之,激活函数的门控机制再次之。
至此,我们完成了从零构建、训练并系统验证一个Transformer语言模型的完整闭环。这个系列不仅是对技术的深入剖析,更是一次对深度学习科研方法论的全景演示。
按顺序完成这组文章,循序渐进地掌握主题
发现错误、内容过时或有改进想法?欢迎告诉我
根据本文分类与标签,为你推荐可能感兴趣的内容
系统讲解语言模型训练的核心系统组件:从数值稳定的交叉熵损失出发,剖析基于np.memmap的高效数据加载器与随机采样批次生成逻辑;从零推导AdamW优化器的完整更新公式;设计余弦退火学习率调度器;实现基于全局L2范数的梯度裁剪以防止梯度爆炸。完整展示从数据到优化器的训练闭环。
阅读文章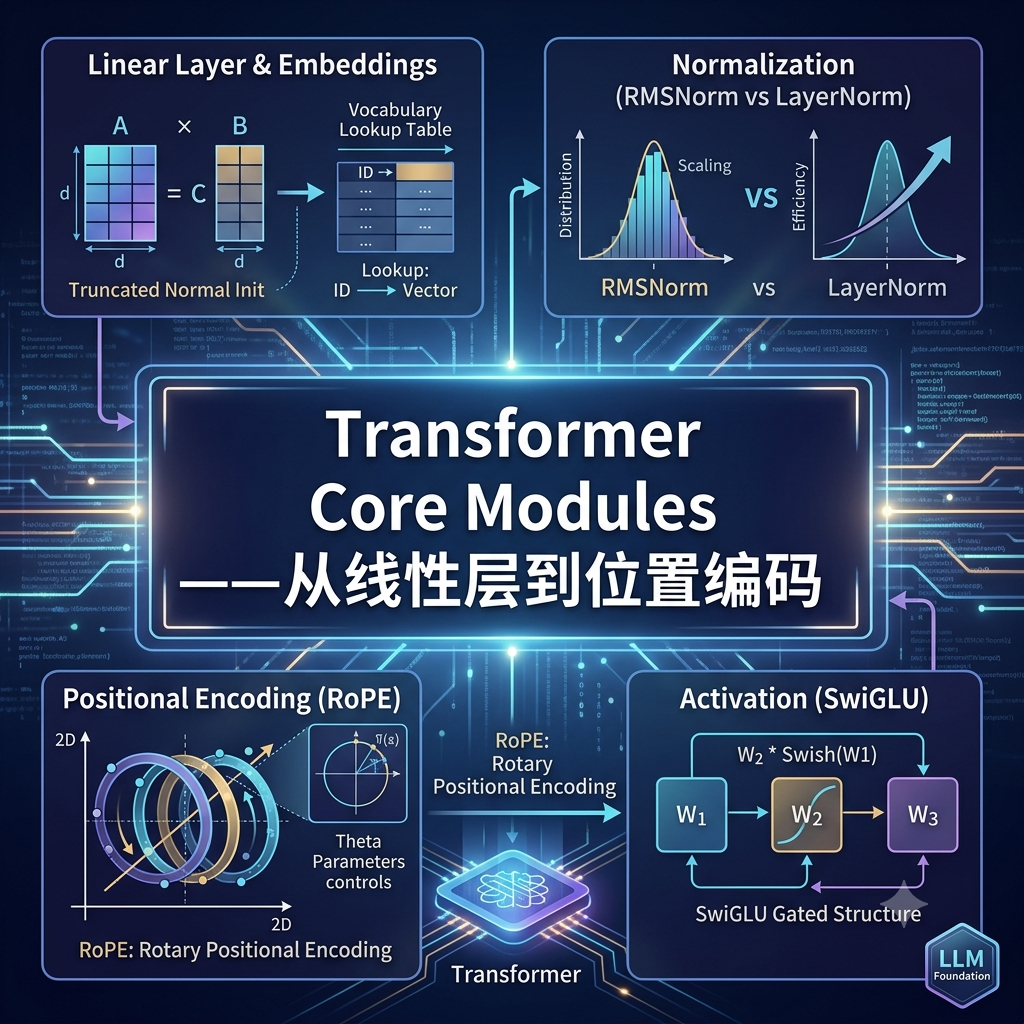
系统讲解Transformer核心模块的从零实现:从线性层的矩阵乘法本质与截断正态初始化策略出发,深入词嵌入层的查表机制与参数规模计算;推导RMSNorm相比LayerNorm的归一化原理与计算效率优势;剖析SwiGLU门控激活函数的三矩阵结构(W₁/W₂/W₃)及其参数量权衡;最后完整推导RoPE旋转位置编码的数学原理——从二维平面旋转矩阵到复数视角的高维扩展,以及theta参数对旋转频率的控制与编码质量的影响。
阅读文章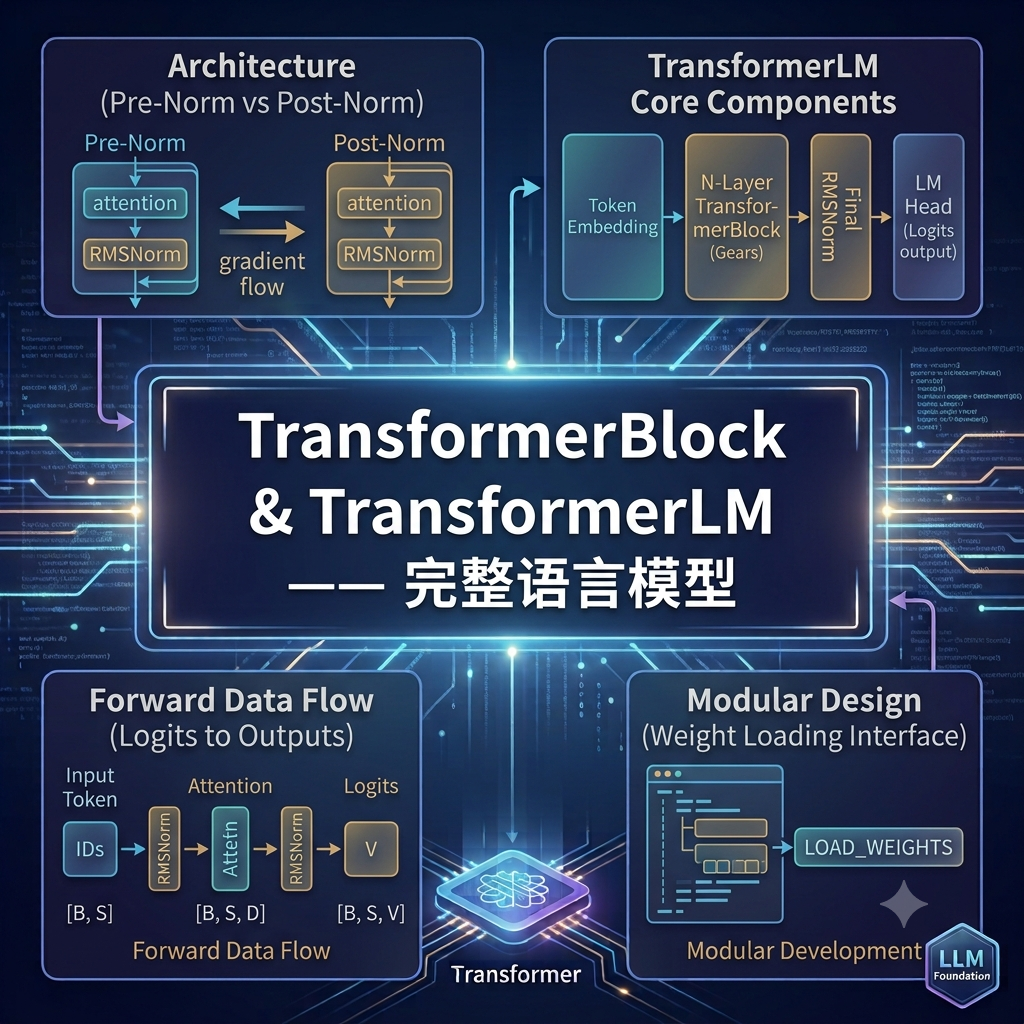
系统讲解如何将Transformer的各个组件组合成完整的可训练语言模型:从TransformerBlock的Pre-Norm与Post-Norm架构对比入手,剖析残差连接如何保障深层网络梯度流动;深入模块化设计中的权重加载接口;拆解TransformerLM四大核心组件(Token Embedding → N层TransformerBlock → Final RMSNorm → LM Head)及其超参数设计的权衡考量;完整跟踪从token ID到logits的前向传播数据流(形状变换全程)。
阅读文章请使用微信扫描二维码分享
当前文章会保持在原页面