


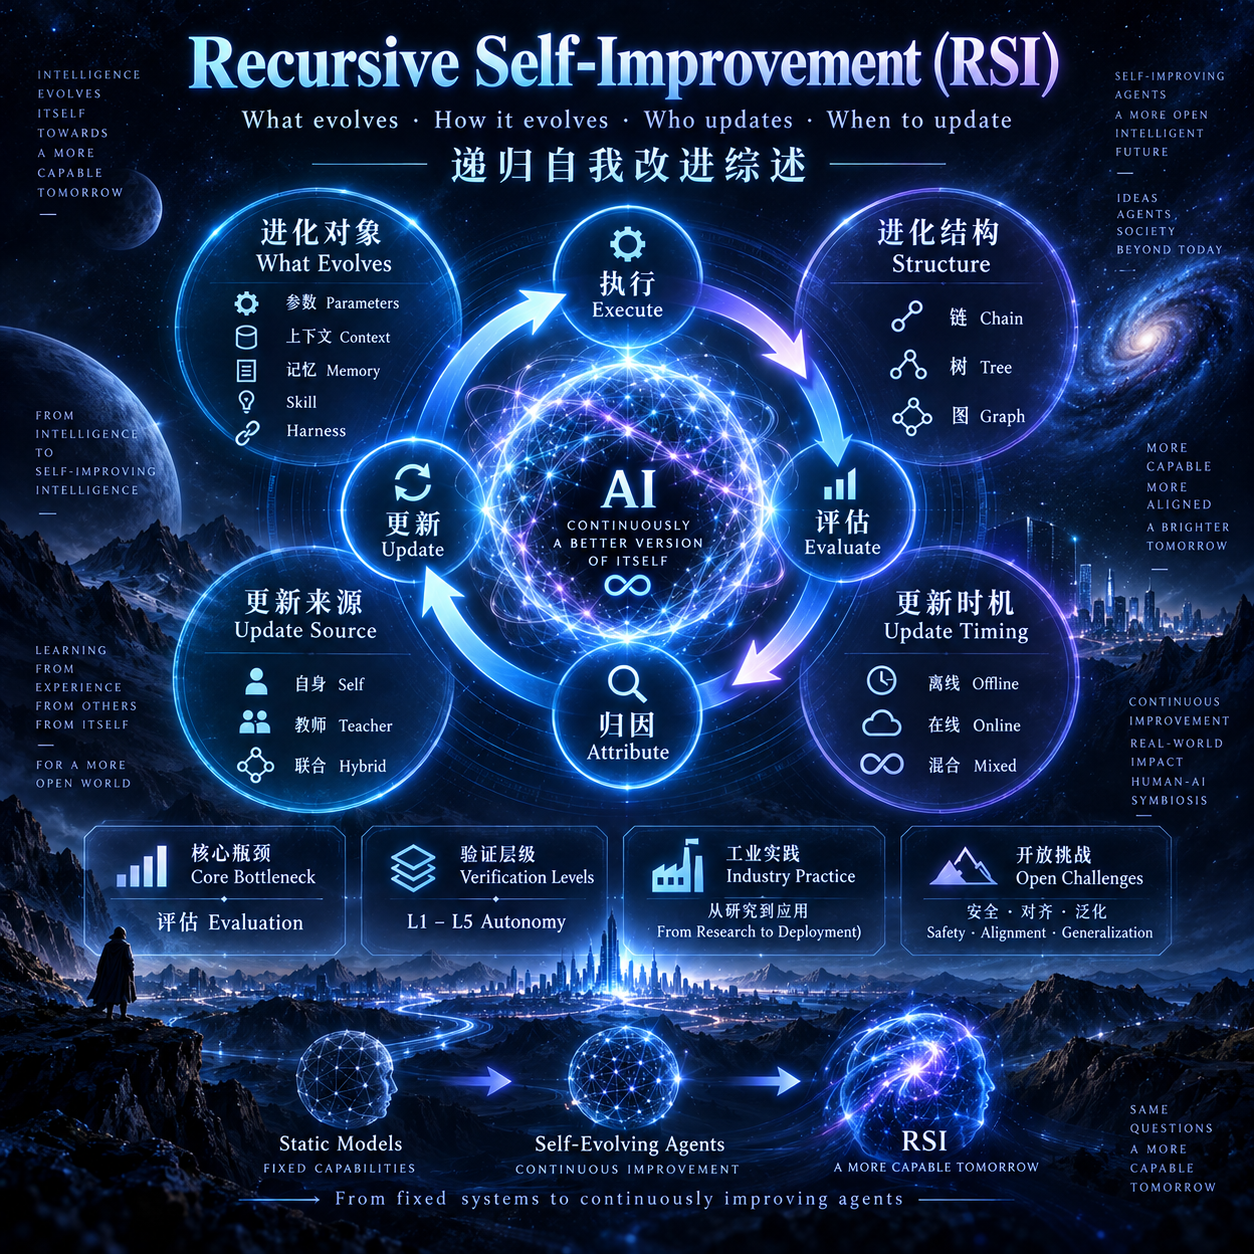
Recursive Self-Improvement(RSI)—— 递归自我改进综述
系统解读递归自我改进(RSI)综述,围绕进化对象(参数、上下文、记忆、Skill、Harness代码)、进化结构(链、树、图)、更新来源(自身、教师、联合)、更新时机(离线、在线、混合)等维度建立 RSI 分类体系,并深入分析评估瓶颈、验证层级、L1-L5 自主性谱系、工业实践与开放挑战。
阅读文章
ZHY's Blog
A UNIVERSE OF IDEAS · BY ZHANG HAOYI
让好奇心 点亮知识宇宙
在代码、模型与思想之间自由漫游。这里持续记录人工智能、机器学习、软件工程与成长实践,让每次阅读都成为一次新的发现。


ARTICLE NOTE
在之前的文章中,我们拆解了Agent的核心架构、主流范式与工具调用机制。然而,无论架构多精巧、范式多先进,所有Agent都面临一个根本性的瓶颈——记忆。
LLM本身是无状态的。每一次调用,模型都像第一次见到用户一样——它不记得昨天的对话,不记得用户的偏好,不记得自己五分钟前得出的结论。对于单轮问答,这不是问题。但对于需要持续交互、跨会话学习、长程推理的Agent来说,这是致命的。
传统的解决方案简单粗暴:把整段对话历史塞进上下文窗口。这种方法在生产环境中问题重重——满上下文不仅带来17秒的p95延迟和14倍的token开销,还会导致模型对早期指令的注意力下降,且没有策展的记忆会把一次性错误固化成永久谎言。一个中等规模SaaS,每月1000万次Agent调用,若走满上下文仅LLM token就大约要花100万美元;同样的工作负载换成选择性记忆会降到约10万美元。
Agent记忆系统正是为此而生。本文将系统讲解Agent记忆系统的三个核心层次:
Agent的记忆需要满足三个核心要求:持久化(跨会话不丢失)、可检索(按语义快速查找)、可扩展(支持海量记忆)。传统的关系数据库无法高效支持语义检索,而向量数据库正是为此而生。
向量数据库的核心抽象极其简洁:将非结构化数据(文本、图像等)转换为高维向量,通过向量相似度实现语义检索。
Agent将信息(如用户偏好、历史对话)嵌入为向量存储在Pinecone、Milvus或腾讯云向量数据库等系统中,当需要回忆时,通过快速相似度搜索检索相关历史数据。
无论选择Milvus还是Pinecone,向量数据库都围绕三个核心概念展开:
Collection(集合) :相当于关系数据库中的“表”,是存储和管理向量的组织单位。在Milvus中,一个实例可以处理多个集合;在Pinecone中,索引与硬件(Pods)紧密结合。
Index(索引) :向量数据库的核心提速依赖向量索引算法,通过“提前构建索引结构”,把全量比对变成局部比对,将检索复杂度从 O(n) 降到 O(log n) 或更低。主流索引包括HNSW、IVF-FLAT、IVF-PQ等。
Embedding(嵌入) :将文本转换为高维向量的过程。嵌入模型的选择直接影响记忆检索的质量——维度决定了表达的丰富度与存储成本之间的权衡。
在实践中,向量数据库很少单独使用。一个成熟的记忆系统通常采用混合存储架构:
实践建议:初期可采用Redis作为缓存层存储短期对话,MongoDB存储长期历史;向量数据库仅在需要语义扩展时引入。
在深入生命周期管理之前,有必要先理解Agent记忆的分类。《Memory in the Age of AI Agents》提出了标准分类法:
| 记忆类型 | 存放什么 | 存储位置 | 生命周期 |
|---|---|---|---|
| 工作记忆 | 当前对话、工具结果、中间推理 | 上下文窗口内部 | 仅限当前会话 |
| 情景记忆 | 过往具体会话记录,带时间戳 | 带元数据的向量数据库 | 数周到数月,带衰减 |
| 语义记忆 | 用户偏好、实体关系、可复用知识 | 向量数据库、知识图谱 | 持久化,带冲突解决 |
| 过程记忆 | 技能、操作流程 | 结构化存储 | 持久化 |
这四种记忆类型各自有独立的后端、生命周期与失效模式。一个好的记忆系统需要同时管理这四种记忆,并让它们协同工作。
最朴素的写入策略是把所有对话历史原封不动地存入向量数据库。但这种策略的问题很明显——原始对话充斥冗余信息,导致检索时召回大量无关内容。
更先进的写入策略包括:
抽取式写入(Extraction) :从对话中提取关键事实、用户偏好等结构化信息,而非存储原始文本。
摘要式写入(Summarization) :将对话历史压缩为摘要存入长期记忆。
重要性评分写入:基于记忆的重要性(如艾宾浩斯遗忘曲线理论)动态调整存储优先级。
记忆检索的核心是从向量数据库中召回与当前查询最相关的记忆片段。检索质量直接决定了Agent能否“想起”正确的事情。
主流检索策略包括:
记忆不是一成不变的。当Agent获得新信息时,可能需要更新已有的记忆。但更新带来了一个棘手的问题:新旧记忆可能相互矛盾。
例如,Agent之前记住了“用户喜欢Python”,但后来用户说“我现在主要用Rust了”。这时记忆系统需要能够检测冲突并解决矛盾。
冲突解决的策略包括:
“遗忘”是记忆系统中最反直觉却最重要的设计。
在传统信息系统中,保存是首要原则,删除意味着数据丢失。但在Agent记忆系统中,战略性遗忘(Strategic Forgetting)不是失败,而是essential feature。
遗忘的必要性来自三个现实约束:
常见的遗忘策略包括:
大语言模型最根本的硬约束是固定长度的上下文窗口。即使是GPT-4,其上下文窗口也有限——这意味着模型一次能“看”的token数是固定的。
这个局限的后果是灾难性的:
直接扩展上下文窗口在技术上可行,但Transformer的自注意力机制导致计算时间和内存成本呈二次方增长。即使克服了计算挑战,研究也表明长上下文模型难以有效利用额外上下文。
MemGPT(Memory-GPT)由UC Berkeley的Packer等人于2023年提出。其核心思想极其优雅:从传统操作系统的分层内存管理中获得灵感。
在操作系统中,物理内存(RAM)容量有限,但通过虚拟内存分页(virtual memory paging) 技术,操作系统在物理内存和磁盘之间交换数据,为应用程序提供了无限虚拟内存的幻觉。
MemGPT将这一范式直接移植到LLM的上下文管理上:
MemGPT将LLM的固定上下文窗口视为“物理内存”,将外部向量数据库视为“磁盘”,通过智能的数据交换,提供“无限上下文”的幻觉。
MemGPT的分层记忆架构包含两个主要层次:
主上下文(Main Context) :类比于RAM/物理内存。这是LLM的固定上下文窗口,包含系统指令、对话内容和工作记忆三部分。主上下文是LLM直接可访问的“工作空间”,但容量有限。
外部上下文(External Context) :类比于磁盘存储。这是LLM上下文窗口之外的任何信息,存储在向量数据库(如LanceDB)中。外部上下文是一个巨大的、可搜索的档案库,存储着海量的历史交互。
MemGPT还进一步将记忆细分为三个层次:
MemGPT最革命性的设计在于:让LLM自己成为记忆管理器。
传统的RAG系统中,记忆管理由外部规则系统处理。而MemGPT通过工具调用(function calling) 让Agent自主决定:
具体来说,MemGPT在上下文中保留了一个可编辑的“系统提示”区域(in-context memory),并给Agent提供了读写工具:
# MemGPT的核心记忆编辑工具def core_memory_append(self, name: str, content: str): """追加内容到核心记忆""" self.memory[name].value += "\n" + content
def core_memory_replace(self, name: str, old_content: str, new_content: str): """替换核心记忆中的内容""" self.memory[name].value = self.memory[name].value.replace(old_content, new_content)Agent通过调用这些工具来主动管理自己的记忆内容——这是传统AI系统中前所未见的自主性。
MemGPT还引入了两个操作系统级别的控制机制:
分页(Paging) :当主上下文即将溢出时,MemGPT将“不活跃”的信息移出主上下文,存储到外部上下文中。当需要时,再将相关信息从外部上下文“换入”主上下文。
中断(Interrupts) :MemGPT利用中断来管理自身与用户之间的控制流。例如,当Agent需要用户输入或确认时,可以触发中断暂停执行。
MemGPT在两个关键领域进行了评估:
在100轮以上的对话中,MemGPT的上下文一致性比传统LLM提升了67%。通过智能的记忆管理,MemGPT可以将推理成本降低90%以上。
MemGPT的研究成果已经演化为Letta(曾用名MemGPT)——一个记忆优先(memory-first)的Agent框架。
Letta将记忆视为一等架构关切(first-class architectural concern) ,而非事后补丁。在Letta中,Agent不仅使用记忆——它们运行在Letta内部,由框架统一管理Agent循环、工具执行、记忆管理和状态持久化。
即使有了MemGPT式的分层管理,主上下文仍然是有限的。在长任务执行过程中,每一轮“调用工具→拿到结果→再思考”都会往历史里追加大量内容。几十轮下来,历史轻松膨胀到几十万token。
撞上窗口上限会发生三件糟心事:
记忆压缩(Summarization / Compaction) 正是为此而生——把“旧的、暂时用不上的”折叠成摘要,腾出空间继续干活。
记忆压缩的核心逻辑可以概括为:
当消息条数超过阈值时,把旧的对话历史交给LLM生成一段摘要,然后用
[system, 摘要, 最近几条消息]替换掉原来的长历史。
这个“判阈值→选切点→切分→生成摘要”的流程是LangChain等框架的压缩内核。
更先进的压缩策略包括:
两级摘要记忆:将原始对话压缩为两层摘要——单任务摘要(细粒度)和宏观摘要(粗粒度),在保持恒定上下文长度的同时保留最重要的信息和决策脉络。
层级摘要打包(Hierarchical Summary Packing) :将大的记忆区域压缩为渐进式、保留来源的摘要,在需要时可以从摘要展开回原始材料。
无损上下文管理(Lossless Context Management) :主动归档每条消息,构建层级摘要结构,可在需要时注入回上下文。
压缩时机:压缩通常在“每次调用大模型之前”触发。当检测到上下文即将溢出时,自动执行压缩。
非破坏性压缩:好的压缩策略不删原稿——原始对话被归档保存,压缩只产生一个“视图”用于当前推理。
渐进式策略:从最便宜的优化手段开始。例如,DeepAgents先尝试截断超长工具参数(如一次性写入几千行文件内容),如果还不够再触发完整的摘要压缩。
手动压缩:让Agent通过工具调用自主决定“我要清场”,给Agent更大的控制权。
Agent记忆系统的演化,本质上是从 “存下来”到“管起来” 的跃迁。
| 阶段 | 核心思想 | 代表技术 |
|---|---|---|
| 存储 | 把记忆存下来 | 向量数据库(Milvus/Pinecone) |
| 管理 | 决定存什么、怎么取、何时忘 | 写入策略、检索策略、遗忘策略 |
| 分层 | 像OS一样管理有限上下文 | MemGPT / Letta |
| 压缩 | 在有限空间中高效存活 | Summary Memory / Compaction |
这四个层次并非替代关系,而是层层递进、互为补充。一个生产级的Agent记忆系统,需要:
正如MemGPT论文所揭示的:**“我们研究如何在继续使用固定上下文模型的同时,提供无限上下文的幻觉。”**这不仅是技术挑战,更是对AI智能本质的深刻思考——真正的智能,不在于拥有多大的“工作台”,而在于知道什么该放在手边、什么该归档、什么该遗忘。
按顺序完成这组文章,循序渐进地掌握主题
发现错误、内容过时或有改进想法?欢迎告诉我
根据本文分类与标签,为你推荐可能感兴趣的内容
系统解读递归自我改进(RSI)综述,围绕进化对象(参数、上下文、记忆、Skill、Harness代码)、进化结构(链、树、图)、更新来源(自身、教师、联合)、更新时机(离线、在线、混合)等维度建立 RSI 分类体系,并深入分析评估瓶颈、验证层级、L1-L5 自主性谱系、工业实践与开放挑战。
阅读文章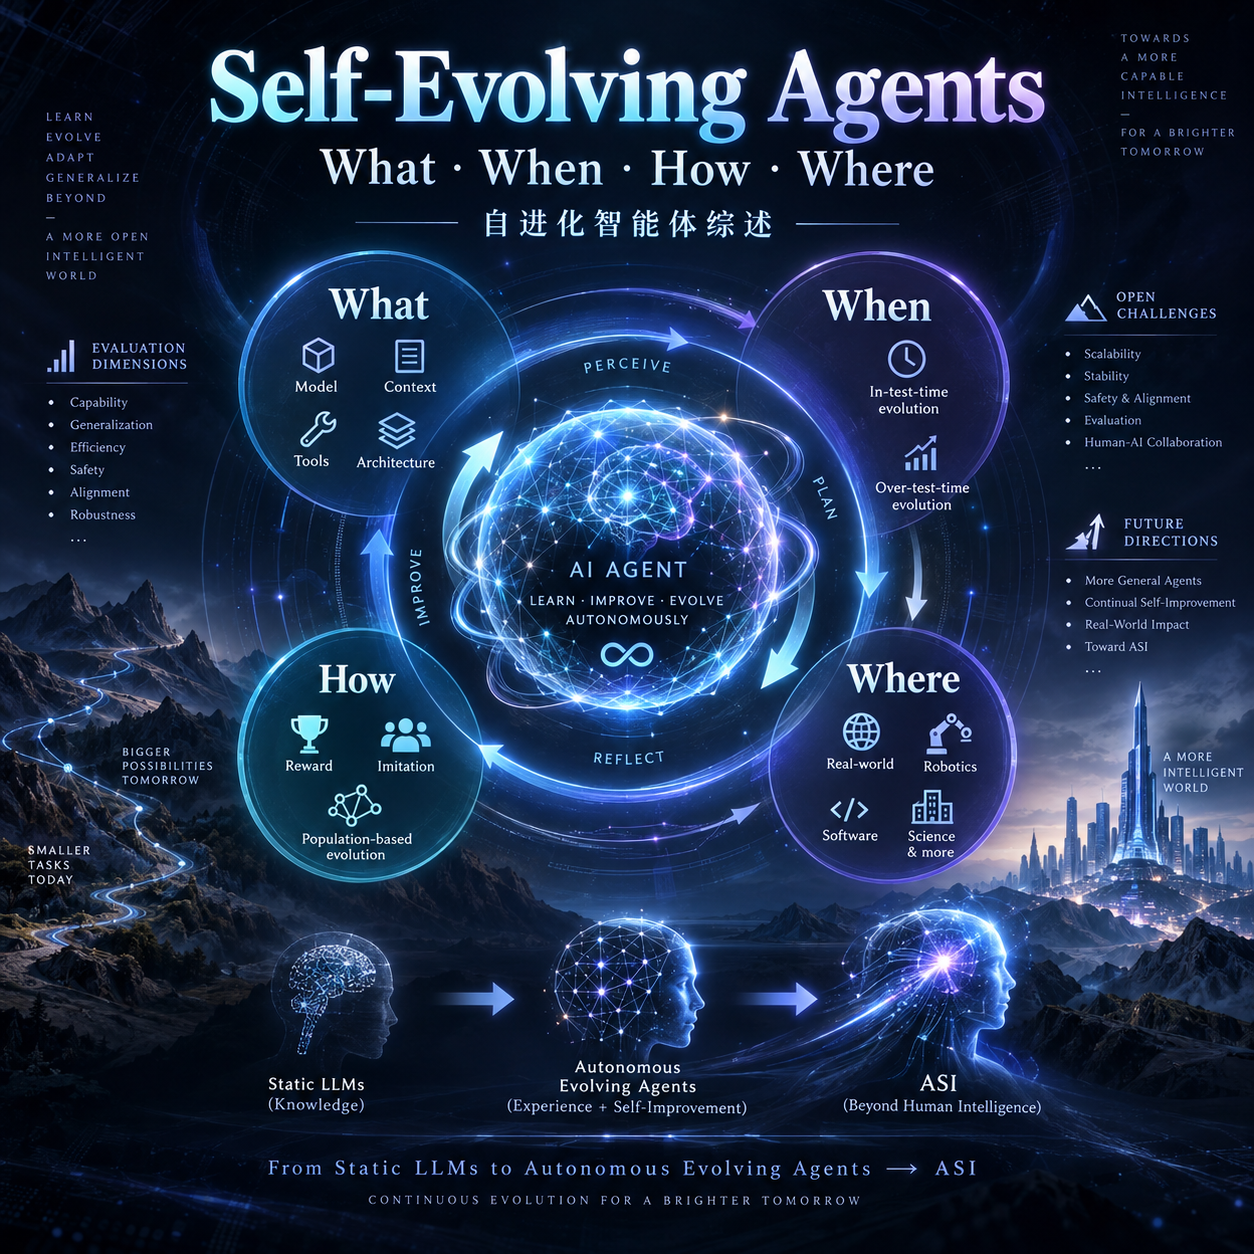
系统解读自进化智能体综述,围绕 What、When、How、Where 四大核心问题,系统梳理自进化智能体的进化对象(模型、上下文、工具、架构)、进化时机(测试时内/测试时间)、进化方法(奖励/模仿/种群)与落地领域,并涵盖五维评估体系、开放挑战与未来方向。
阅读文章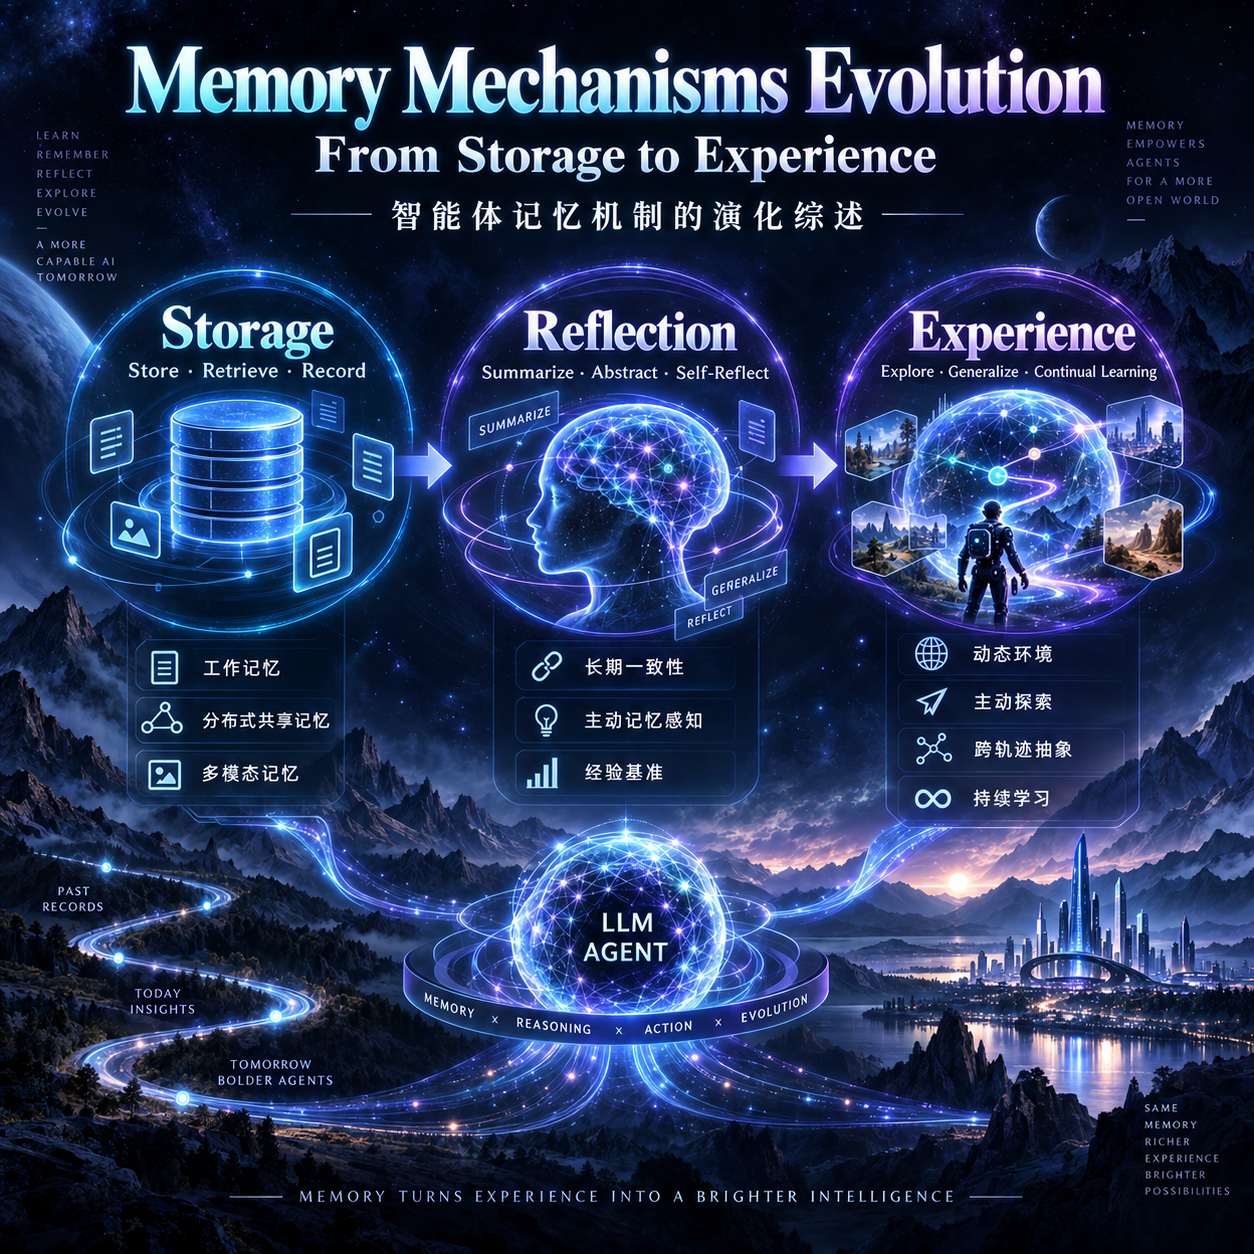
系统梳理 LLM Agent 记忆机制从 Storage、Reflection 到 Experience 的演化框架。解析长期一致性、动态环境与持续学习三大驱动,剖析主动探索与跨轨迹抽象两大变革机制,并展望主动记忆感知、工作记忆、经验基准、分布式共享记忆与多模态记忆等未来方向。
阅读文章请使用微信扫描二维码分享
当前文章会保持在原页面