


Transformer Inference Generation —— 推理生成式语言模型
系统讲解语言模型推理生成的完整技术栈:从自回归生成的本质出发,剖析温度采样、Top-k采样与Top-p三种生成策略的工作原理与参数调节;详解从检查点恢复训练权重的加载机制;完整拆解从原始文本到生成文本的端到端推理数据流;深入剖析KV Cache的核心原理及其代价与前沿优化方向。全文总结整个从零构建Transformer系列的技术栈全景与未来扩展方向。
阅读文章
ZHY's Blog
A UNIVERSE OF IDEAS · BY ZHANG HAOYI
让好奇心 点亮知识宇宙
在代码、模型与思想之间自由漫游。这里持续记录人工智能、机器学习、软件工程与成长实践,让每次阅读都成为一次新的发现。


7 篇文章 · 分类
系统讲解语言模型推理生成的完整技术栈:从自回归生成的本质出发,剖析温度采样、Top-k采样与Top-p三种生成策略的工作原理与参数调节;详解从检查点恢复训练权重的加载机制;完整拆解从原始文本到生成文本的端到端推理数据流;深入剖析KV Cache的核心原理及其代价与前沿优化方向。全文总结整个从零构建Transformer系列的技术栈全景与未来扩展方向。
阅读文章
系统讲解基于argparse的命令行训练脚本设计与五组消融实验的科学验证:从高度参数化的训练框架出发,设计五组对照实验以量化各组件贡献;基于训练损失/验证损失/困惑度/梯度范数等多维度指标分析,得出各组件重要性排序;展示完整的训练循环实现及自动化批量实验的工程价值。附有完整命令行参数体系与实验配置。
阅读文章
系统讲解语言模型训练的核心系统组件:从数值稳定的交叉熵损失出发,剖析基于np.memmap的高效数据加载器与随机采样批次生成逻辑;从零推导AdamW优化器的完整更新公式;设计余弦退火学习率调度器;实现基于全局L2范数的梯度裁剪以防止梯度爆炸。完整展示从数据到优化器的训练闭环。
阅读文章
系统讲解如何将Transformer的各个组件组合成完整的可训练语言模型:从TransformerBlock的Pre-Norm与Post-Norm架构对比入手,剖析残差连接如何保障深层网络梯度流动;深入模块化设计中的权重加载接口;拆解TransformerLM四大核心组件(Token Embedding → N层TransformerBlock → Final RMSNorm → LM Head)及其超参数设计的权衡考量;完整跟踪从token ID到logits的前向传播数据流(形状变换全程)。
阅读文章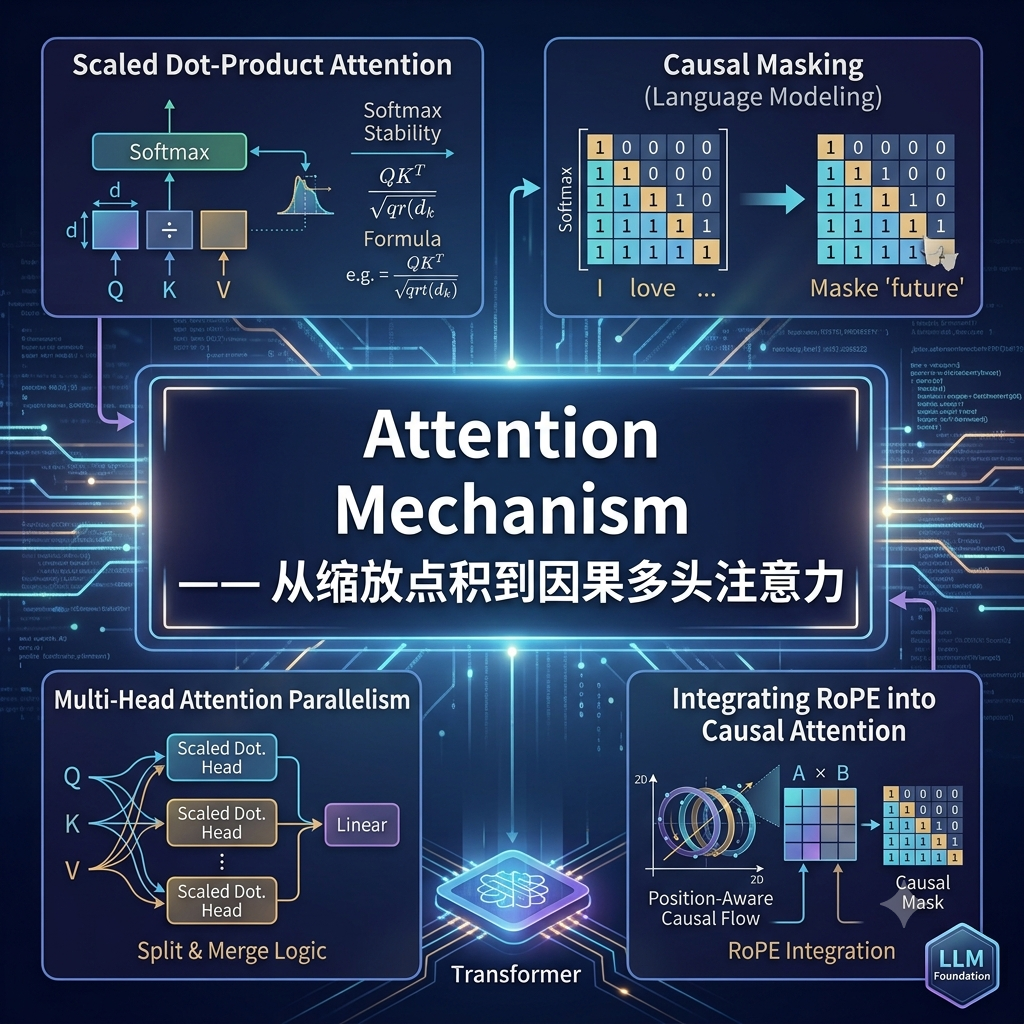
系统讲解Transformer注意力机制的核心原理与完整实现:从数值稳定的Softmax出发,推导缩放点积注意力的数学公式与几何意义;深入剖析因果掩码的下三角矩阵机制及其在自回归语言模型中的关键作用;详解多头注意力的拆分与合并逻辑及并行计算优势;最后阐述RoPE旋转位置编码如何直接融入注意力计算,与因果掩码协同实现带位置感知的因果注意力。
阅读文章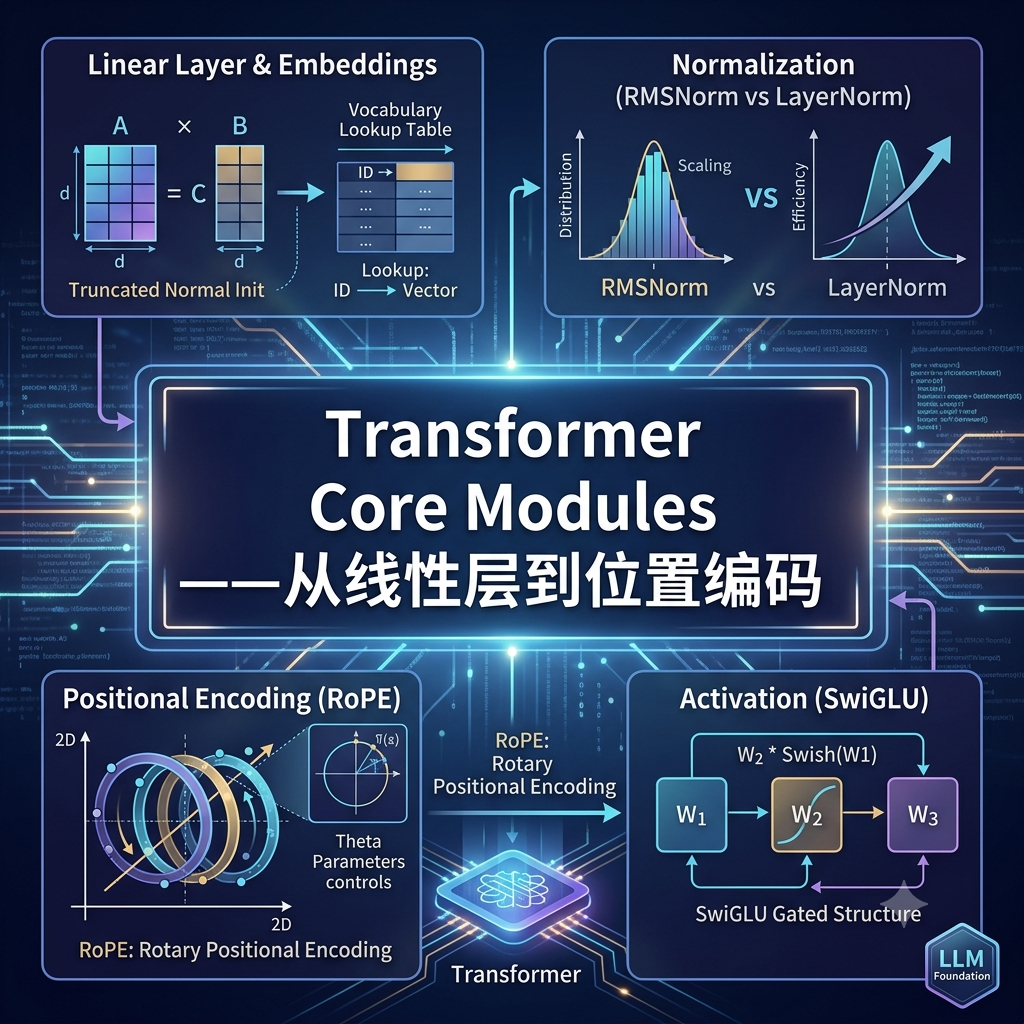
系统讲解Transformer核心模块的从零实现:从线性层的矩阵乘法本质与截断正态初始化策略出发,深入词嵌入层的查表机制与参数规模计算;推导RMSNorm相比LayerNorm的归一化原理与计算效率优势;剖析SwiGLU门控激活函数的三矩阵结构(W₁/W₂/W₃)及其参数量权衡;最后完整推导RoPE旋转位置编码的数学原理——从二维平面旋转矩阵到复数视角的高维扩展,以及theta参数对旋转频率的控制与编码质量的影响。
阅读文章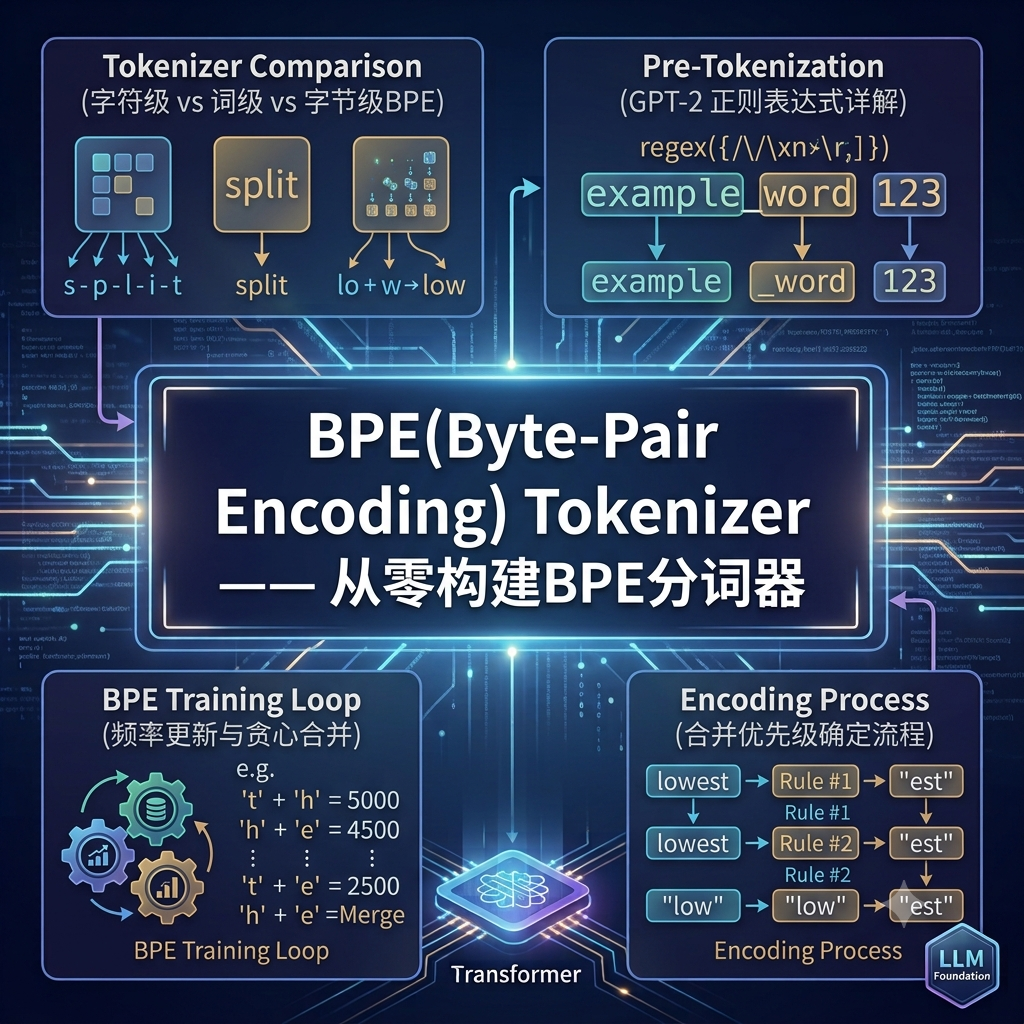
系统讲解字节级BPE(Byte-Pair Encoding)分词器的完整实现原理与代码。从词级分词与字符级分词的困境出发,剖析GPT-2风格字节级BPE的优势;详细拆解预分词阶段GPT-2正则表达式含义;深入推导BPE训练的核心数据结构与贪心合并循环的频率更新逻辑;详解编码时按合并优先级应用规则的确定性流程;最后在TinyStories数据集上训练出18,017词汇量的分词器并生成.dat文件供模型训练使用。
阅读文章