



Agent Architecture —— LLM & Planning & Tool & Memory
系统讲解AI Agent的核心架构——LLM(推理引擎)、规划(Planning)、工具(Tools)与记忆(Memory)四大模块的设计原理与协同机制。从感知-规划-行动闭环出发,剖析LLM作为“中央推理引擎”的多重角色、规划的数学建模与两种范式、工具调用的标准化接口与MCP协议演进,以及短期记忆与长期记忆的二分法设计。
阅读文章
ZHY's Blog
A UNIVERSE OF IDEAS · BY ZHANG HAOYI
让好奇心 点亮知识宇宙
在代码、模型与思想之间自由漫游。这里持续记录人工智能、机器学习、软件工程与成长实践,让每次阅读都成为一次新的发现。


ARTICLE NOTE
大语言模型虽然强大,但它的知识截止于训练数据的那一天。当用户问“昨天发生了什么新闻”时,模型要么胡编乱造(幻觉),要么承认不知道。
检索增强生成(Retrieval-Augmented Generation, RAG) 的解决思路极其优雅:不让模型闭卷考试,而是允许它开卷——先从外部知识库中检索相关文档,再把文档和问题一起交给模型生成答案。RAG通过注入外部知识来提升LLM的事实准确性。
一个标准的RAG系统包含三个核心阶段:
本文将从数学原理和工程实践出发,系统讲解RAG的三个核心环节——索引(分块策略) 、检索(ANN算法) 与重排序(Reranker) ,并介绍HyDE这一前沿检索增强技术。
在将文档存入向量数据库之前,必须先将其分割成更小的片段——分块(Chunking) 。分块方式对检索质量的影响,超过RAG流水线中几乎任何其他决策。
核心矛盾非常直观:
没有普遍适用的“最佳”块大小。正确的尺寸取决于文档类型、查询模式、嵌入模型的token限制以及LLM需要多少上下文才能生成好答案。
最直观的方法:按预定义的字符数或token数将文本切成大小统一的块。
from langchain.text_splitter import CharacterTextSplitter
splitter = CharacterTextSplitter( chunk_size=500, chunk_overlap=50, # 重叠区缓解上下文断裂 separator="\n")chunks = splitter.split_documents(docs)工作原理:一个滑动窗口在文档上移动,产生等大小的块。通常设置10–20%的重叠,让上一个块末尾的内容在下一个块开头重复出现,减少关键句被切断的风险。
优缺点:
适用场景:快速原型验证、同质化纯文本语料、需要以最低延迟索引海量数据的场景。
这是一种更智能的组合式策略:按优先级顺序尝试多种分隔符进行递归分割。
工作原理:首先尝试用段落分隔符(\n\n)分割;如果段落仍然过大,再按句子分割;最后才按字符数强制分割。
from langchain.text_splitter import RecursiveCharacterTextSplitter
splitter = RecursiveCharacterTextSplitter( chunk_size=500, chunk_overlap=50, separators=["\n\n", "\n", "。", ",", " "] # 优先级从高到低)递归分块是LangChain和LlamaIndex的默认策略,最适合通用文章、博客文章和混合内容。
不再基于字符数,而是基于语义边界进行分割。
工作原理:
from sentence_transformers import SentenceTransformerimport numpy as np
model = SentenceTransformer('paraphrase-MiniLM-L6-v2')
def semantic_chunking(sentences, threshold=0.85): chunks = [] current_chunk = [sentences[0]]
for i in range(1, len(sentences)): emb1 = model.encode(current_chunk[-1]) emb2 = model.encode(sentences[i]) sim = np.dot(emb1, emb2) / (np.linalg.norm(emb1) * np.linalg.norm(emb2))
if sim > threshold: current_chunk.append(sentences[i]) else: chunks.append(" ".join(current_chunk)) current_chunk = [sentences[i]]
return chunks语义分块保持了语言的自然流畅,保留了完整的思想单元,因此检索准确率更高。挑战在于阈值选择——不同文档的最佳阈值可能不同。
| 策略 | 速度 | 质量 | 适用场景 |
|---|---|---|---|
| 固定大小 | 最快 | 最低 | 快速原型、结构化数据 |
| 递归 | 快 | 中等 | 通用文章、博客(默认首选) |
| 语义 | 较慢 | 最高 | 需要高质量检索的场景 |
实践中,递归分块是大多数RAG系统的最佳起点。如果检索质量不满足要求,再考虑升级到语义分块。
分块完成后,每个块通过嵌入模型转换为高维向量(通常128–4096维)。当用户提出查询时,系统需要在高维向量空间中找到与查询向量最相似的Top-K个向量。
最直接的方法是暴力搜索(FLAT) :计算查询向量与所有向量的距离,排序后取Top-K:
def flat_search(query_vector, vectors_db, top_k): distances = [euclidean_distance(query_vector, v) for v in vectors_db] return sorted(zip(distances, vectors_db))[:top_k]暴力搜索的时间复杂度为 O(n×d) (n为向量数量,d为维度)。在百万级数据下,延迟达到10–100ms,十亿级则完全不可用。
近似最近邻搜索(Approximate Nearest Neighbor, ANN) 应运而生:牺牲少量准确率,换取数量级的性能提升。ANN索引能将百万级搜索延迟从秒级压缩到毫秒级。
HNSW(Hierarchical Navigable Small World,分层可导航小世界) 是当前最流行的ANN算法之一。
核心思想:构建多层图结构——底层包含所有节点,上层是下层的稀疏子集。
工作原理:
形象地说,HNSW像在多层高速路网中导航:先在顶层高速上快速前进(跳过大量无关节点),然后逐层下到更细的路网,最终精确定位。
数学本质:HNSW通过图结构将搜索空间从 O(n) 降低到 O(log n) 。某开源向量数据库的基准测试显示,采用HNSW算法的千万级向量检索比暴力搜索快3个数量级。
优缺点:
适用场景:数据规模适中(百万到千万级)、内存充裕、对查询延迟要求极高的场景。
当数据规模达到亿级甚至十亿级时,HNSW的内存占用可能成为瓶颈。IVF-PQ(倒排文件 + 乘积量化) 通过量化压缩将内存占用降低10倍以上。
IVF(倒排文件) :通过K-means聚类将数据划分为多个簇(通常100–1000个),检索时先定位候选簇,再在簇内搜索。
PQ(乘积量化) :将高维向量分割为多个子向量,对每个子空间进行聚类,用聚类中心索引替代原始向量存储。
压缩效果惊人:
优缺点:
| 算法 | 内存占用 | 查询延迟 | 准确率 | 适用数据规模 |
|---|---|---|---|---|
| FLAT(暴力) | 极高 | 极慢 | 100% | <10万 |
| HNSW | 高 | 极快(毫秒级) | 95–99% | 百万–千万级 |
| IVF-PQ | 极低 | 较快 | 90–95% | 亿级+ |
选型建议:
第一阶段的ANN检索优化的是召回(Recall) ——确保相关文档不被漏掉。但召回的Top-K中,最相关的文档不一定排在第一位。
这个问题的代价有多大?模型只读取提示词中的内容。如果正确的块排在第7位,它和第700位没什么区别。
重排序(Reranking) 就是来解决这个问题的:用一个更精确但更慢的模型,对初排返回的少量候选(50–100个)进行重新打分和排序,把最相关的推到最前面。
理解重排序,首先需要理解两种编码器架构的根本区别:
Bi-Encoder(双编码器) :查询和文档分别独立编码成向量,然后计算向量相似度。
Query → Encoder → q_vector ─┐ ├→ 相似度计算Doc → Encoder → d_vector ─┘Bi-Encoder的优势是速度快——文档向量可以预先计算并存储,查询时只需要编码查询向量一次。缺点是交互不足——查询和文档在编码过程中互不知晓对方的存在。
Cross-Encoder(交叉编码器) :查询和文档拼接在一起,作为一个整体输入模型。
[Query + Doc] → Encoder → 相关性分数Cross-Encoder的优势是精度高——模型可以在编码过程中让查询和文档的token充分交互,深层理解语义关系。缺点是速度慢——每对(查询,文档)都需要独立计算,无法预计算。
重排序的核心逻辑:用Bi-Encoder做快速召回(50–100个候选),用Cross-Encoder做精准排序(选出Top-3~5)。
一份真实的RAG系统评测数据显示:
| 阶段 | Recall@5 | NDCG@5 | MRR |
|---|---|---|---|
| 纯向量检索 | 0.88 | 0.75 | 0.74 |
| 混合检索+RRF | 0.90 | 0.79 | 0.78 |
| + Reranker精排 | 0.90 | 0.85 | 0.88 |
Reranker不改变候选集(Recall不变),但NDCG提升了0.06,MRR提升了0.09。这意味着最相关的文档被推到了更靠前的位置——这正是Reranker的价值所在。
MRR(Mean Reciprocal Rank) 衡量的是第一个正确答案的排名倒数。MRR从0.78提升到0.88,意味着第一个正确答案的平均排名从约1.28提升到了约1.14——首条命中率显著提高。
在生产环境中,一个设计良好的重排序层可以将 precision@3提升40–60% ,增加延迟不到200ms。
当前生产环境中最主流的三个Reranker:
BGE-Reranker-v2-m3(BAAI开源):约5.68亿参数,多语言,CPU上对50个候选批处理约80ms。开源方案的首选。
Cohere Rerank(托管API):商业方案,精度高但需要付费。
Voyage rerank-2:新兴方案。
from sentence_transformers import CrossEncoderfrom typing import List, Tuple
class Reranker: def __init__(self, model_name: str = "BAAI/bge-reranker-v2-m3"): """ 初始化Cross-Encoder重排序器 """ self.model = CrossEncoder(model_name)
def rerank(self, query: str, candidates: List[str], top_k: int = 5) -> List[Tuple[str, float]]: """ 对候选文档进行重排序
数学上,这等价于: score_i = CrossEncoder(query, doc_i) for each candidate i sorted_candidates = sort_by_score(descending)
Cross-Encoder将query和doc拼接后一起编码, 让两者充分交互,产生更精确的相关性分数 """ # 构建(query, document)对 pairs = [(query, doc) for doc in candidates]
# Cross-Encoder计算相关性分数 scores = self.model.predict(pairs)
# 按分数降序排列 ranked = sorted(zip(candidates, scores), key=lambda x: x[1], reverse=True)
return ranked[:top_k]
# 使用示例reranker = Reranker()query = "什么是检索增强生成?"candidates = [...] # 从向量数据库检索到的50-100个候选top_results = reranker.rerank(query, candidates, top_k=5)工程实践要点:
传统RAG的检索流程是:Query → Embedding → Vector Search → Retrieved Chunks。
问题在于:向量数据库基于语义相似度检索,但相似≠相关。
举例来说,用户问:“LangSmith如何帮助监控LLM应用?”如果存储的文档里从未出现过“monitor”、“tracking”或“observability”这些词,哪怕文档里其实写了答案,检索质量也会大打折扣。
本质原因是:短查询的语义信息量太少,无法充分表达用户的真实意图。
HyDE(Hypothetical Document Embeddings,假设性文档嵌入) 由Luyu Gao等人提出。核心思路极其简洁而巧妙:
不直接嵌入用户的查询,而是先让LLM生成一份“假设性答案文档”,再嵌入这份假设文档去检索。
传统RAG: Query → Embed → SearchHyDE: Query → LLM生成假设文档 → Embed假设文档 → Search生成的假设文档比原始短查询承载了更丰富的语义。检索系统搜索的是“上下文意图”而非“关键词匹配”。
传统密集检索中,查询和文档被编码为单向量表示,检索基于向量相似度。
HyDE的核心创新在于将查询从“问题空间”映射到“答案空间” :
设查询为 ,传统方法直接检索:
HyDE引入一个生成步骤:
由于假设文档 在语义上更接近真实文档的分布(都是“答案”而非“问题”),嵌入空间中的距离更小,检索准确率更高。
def hyde_retrieve(query: str, llm, embed_model, vector_db, top_k: int = 10) -> List[str]: """ HyDE检索流程 """ # 1. 生成假设性答案文档 prompt = f""" 请为以下问题生成一个详细的答案文档。即使你不确定答案,也请生成一个合理的假设性答案。
问题: {query}
假设性答案: """ hypothetical_doc = llm.generate(prompt)
# 2. 嵌入假设文档(而非原始查询) query_embedding = embed_model.encode(hypothetical_doc)
# 3. 用假设文档的嵌入进行向量检索 results = vector_db.search(query_embedding, top_k=top_k)
return results优点:
注意事项:
RAG的检索质量,取决于索引、检索、重排序三个环节的协同优化:
第一级:索引(分块策略) ——决定了“知识库”的质量。分块太粗,检索精度下降;分块太细,上下文割裂。递归分块是最稳妥的起点。
第二级:检索(ANN算法) ——决定了“找得到”的速度和广度。HNSW提供极致的查询速度,IVF-PQ提供极致的存储效率。根据数据规模选择——百万级用HNSW,亿级用IVF-PQ。
第三级:重排序(Reranker) ——决定了“排得准”的精度。Cross-Encoder虽然慢,但只对少量候选操作,用200ms的延迟换取40–60%的精度提升,是RAG流水线中性价比最高的环节。
而HyDE则是在检索之前增加了一道“理解意图”的工序——让LLM先“想”后“搜” ,从“匹配关键词”升级到“理解意图”。
正如一位工程师所说:“你的检索器可以在Top-10上统计优秀,却仍然把错误的Top-3交给LLM。”RAG工程的核心,就是确保最相关的文档出现在LLM看到的前几个位置。
按顺序完成这组文章,循序渐进地掌握主题
发现错误、内容过时或有改进想法?欢迎告诉我
根据本文分类与标签,为你推荐可能感兴趣的内容
系统讲解AI Agent的核心架构——LLM(推理引擎)、规划(Planning)、工具(Tools)与记忆(Memory)四大模块的设计原理与协同机制。从感知-规划-行动闭环出发,剖析LLM作为“中央推理引擎”的多重角色、规划的数学建模与两种范式、工具调用的标准化接口与MCP协议演进,以及短期记忆与长期记忆的二分法设计。
阅读文章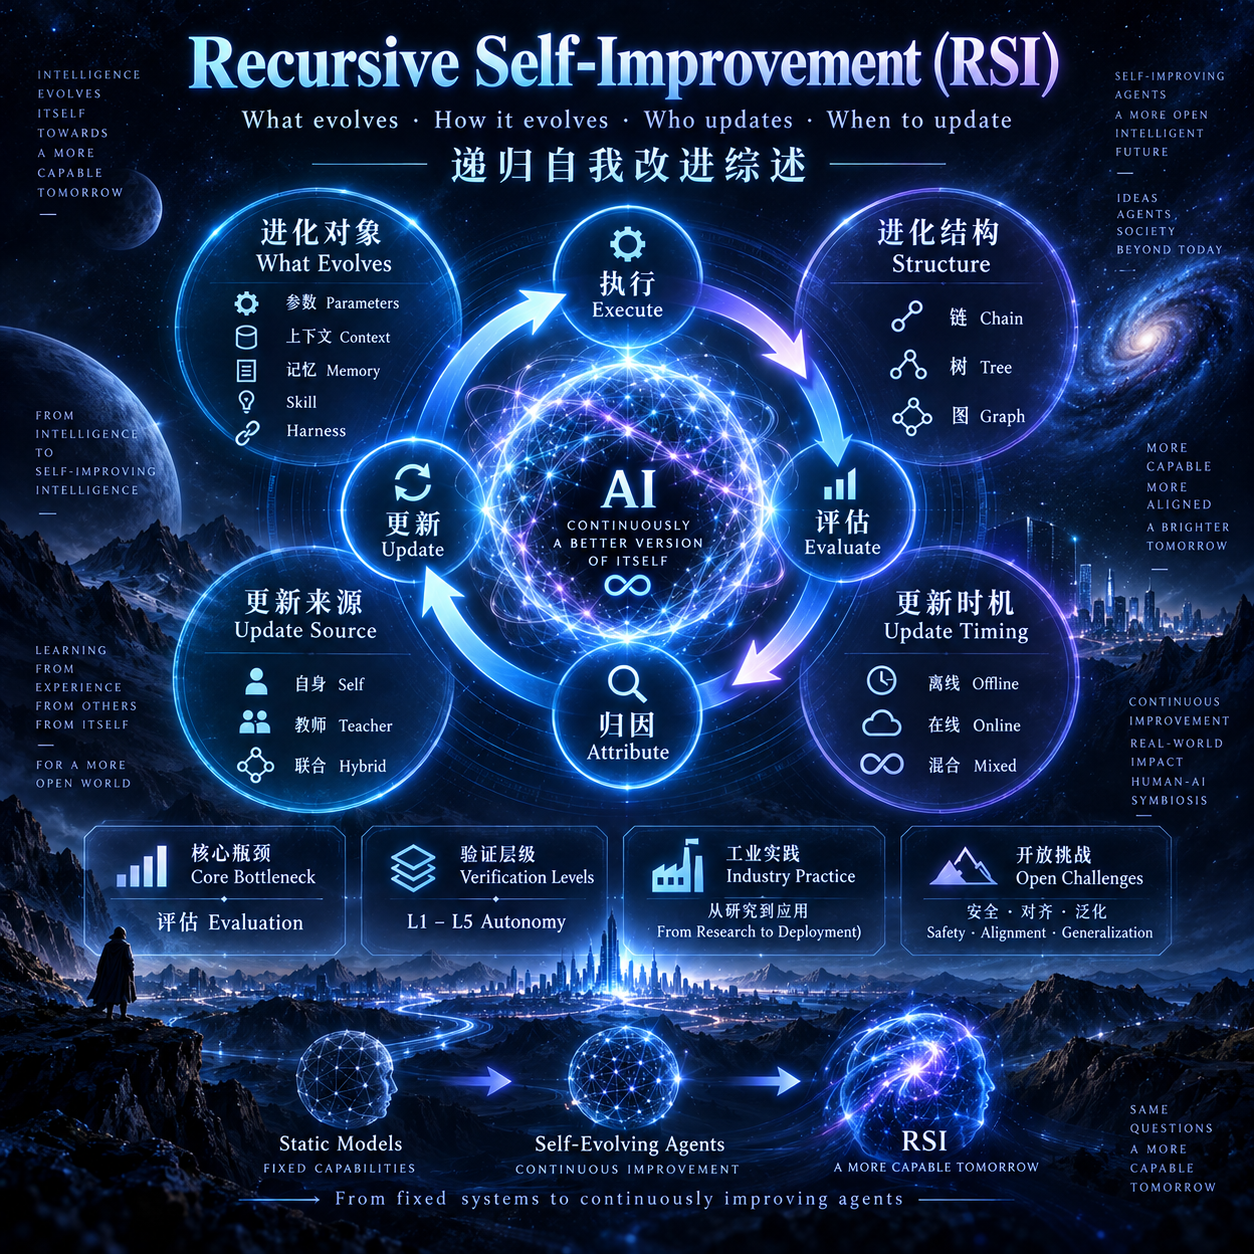
系统解读递归自我改进(RSI)综述,围绕进化对象(参数、上下文、记忆、Skill、Harness代码)、进化结构(链、树、图)、更新来源(自身、教师、联合)、更新时机(离线、在线、混合)等维度建立 RSI 分类体系,并深入分析评估瓶颈、验证层级、L1-L5 自主性谱系、工业实践与开放挑战。
阅读文章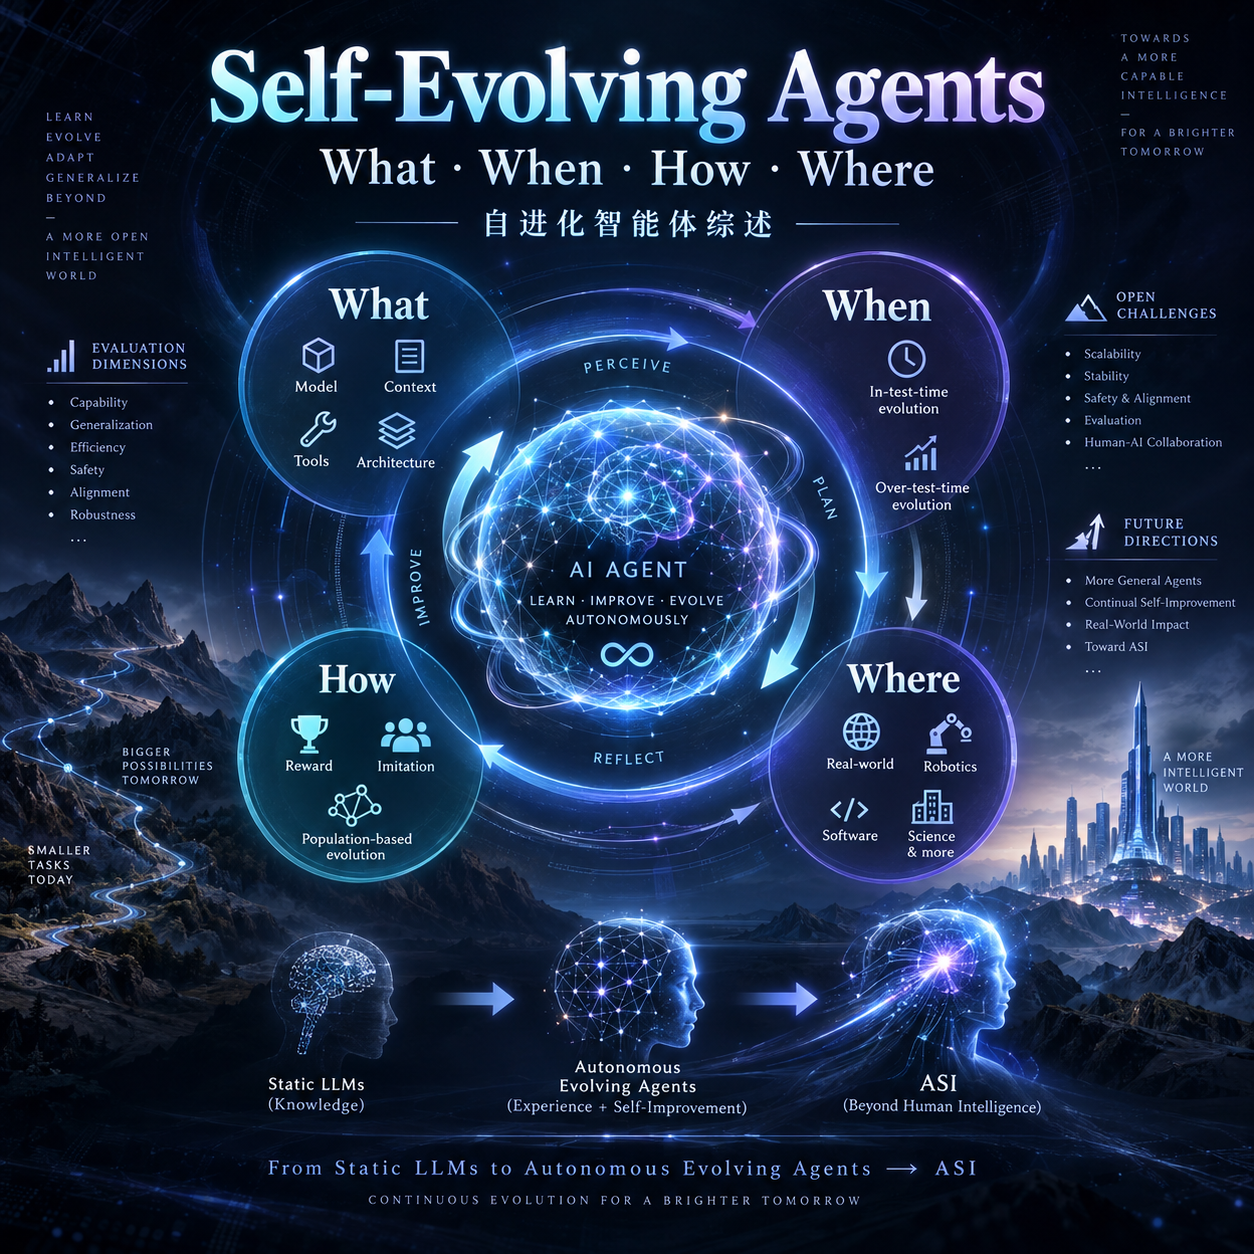
系统解读自进化智能体综述,围绕 What、When、How、Where 四大核心问题,系统梳理自进化智能体的进化对象(模型、上下文、工具、架构)、进化时机(测试时内/测试时间)、进化方法(奖励/模仿/种群)与落地领域,并涵盖五维评估体系、开放挑战与未来方向。
阅读文章请使用微信扫描二维码分享
当前文章会保持在原页面