


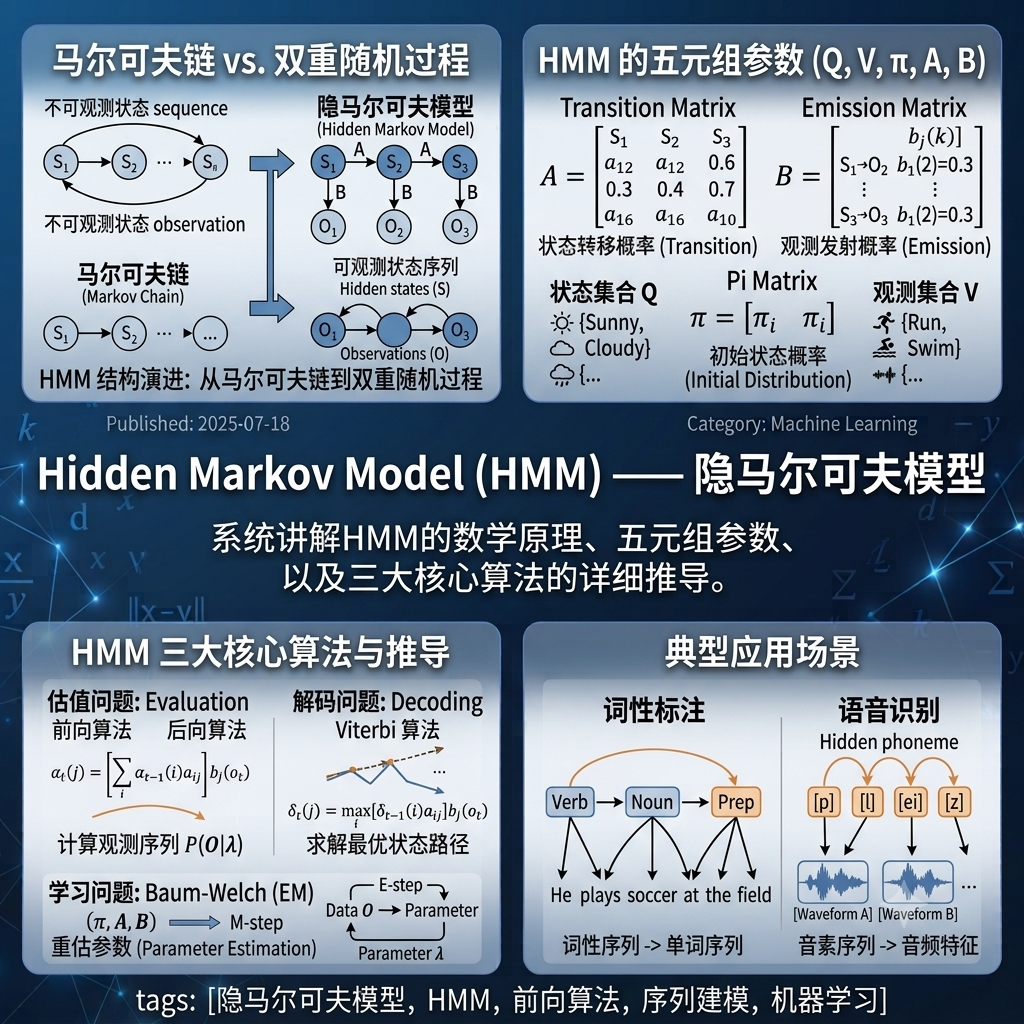
Hidden Markov Model (HMM) —— 隐马尔可夫模型
系统讲解隐马尔可夫模型(HMM)的完整数学原理与三大核心算法:从马尔可夫链到双重随机过程的演进出发,定义HMM的五元组参数(Q, V, π, A, B);详细推导估值问题、解码问题和学习问题;并通过词性标注、语音识别等经典应用场景展示HMM的实践价值。
阅读文章
ZHY's Blog
A UNIVERSE OF IDEAS · BY ZHANG HAOYI
让好奇心 点亮知识宇宙
在代码、模型与思想之间自由漫游。这里持续记录人工智能、机器学习、软件工程与成长实践,让每次阅读都成为一次新的发现。


15 篇文章 · 分类
系统讲解隐马尔可夫模型(HMM)的完整数学原理与三大核心算法:从马尔可夫链到双重随机过程的演进出发,定义HMM的五元组参数(Q, V, π, A, B);详细推导估值问题、解码问题和学习问题;并通过词性标注、语音识别等经典应用场景展示HMM的实践价值。
阅读文章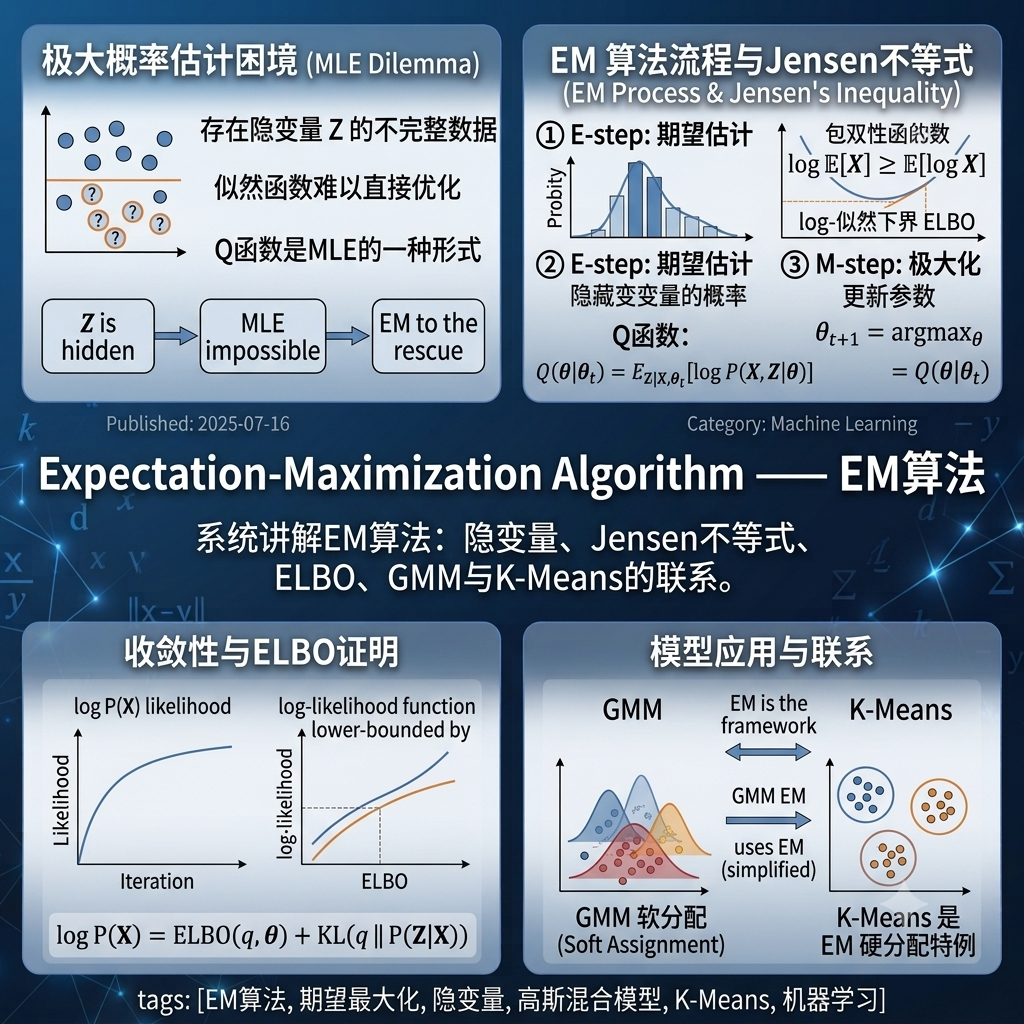
系统讲解期望最大化(EM)算法的完整数学原理:从极大似然估计在隐变量存在时的困境出发,推导E步与M步的迭代框架;基于Jensen不等式证明ELBO证据下界与收敛性;通过二硬币模型与高斯混合模型(GMM)两个完整实例展示EM的具体计算流程;揭示K-Means是EM在硬分配下的特例这一深层联系。
阅读文章
系统讲解K-Means聚类的核心原理与算法细节,涵盖Lloyd交替优化算法的收敛性分析、K-Means作为EM算法特例的理论联系(硬分配 vs 软分配)、K-Means++初始化策略的D²采样机制与O(log K)近似保证,以及肘部法则与轮廓系数的选择K值方法及其局限。
阅读文章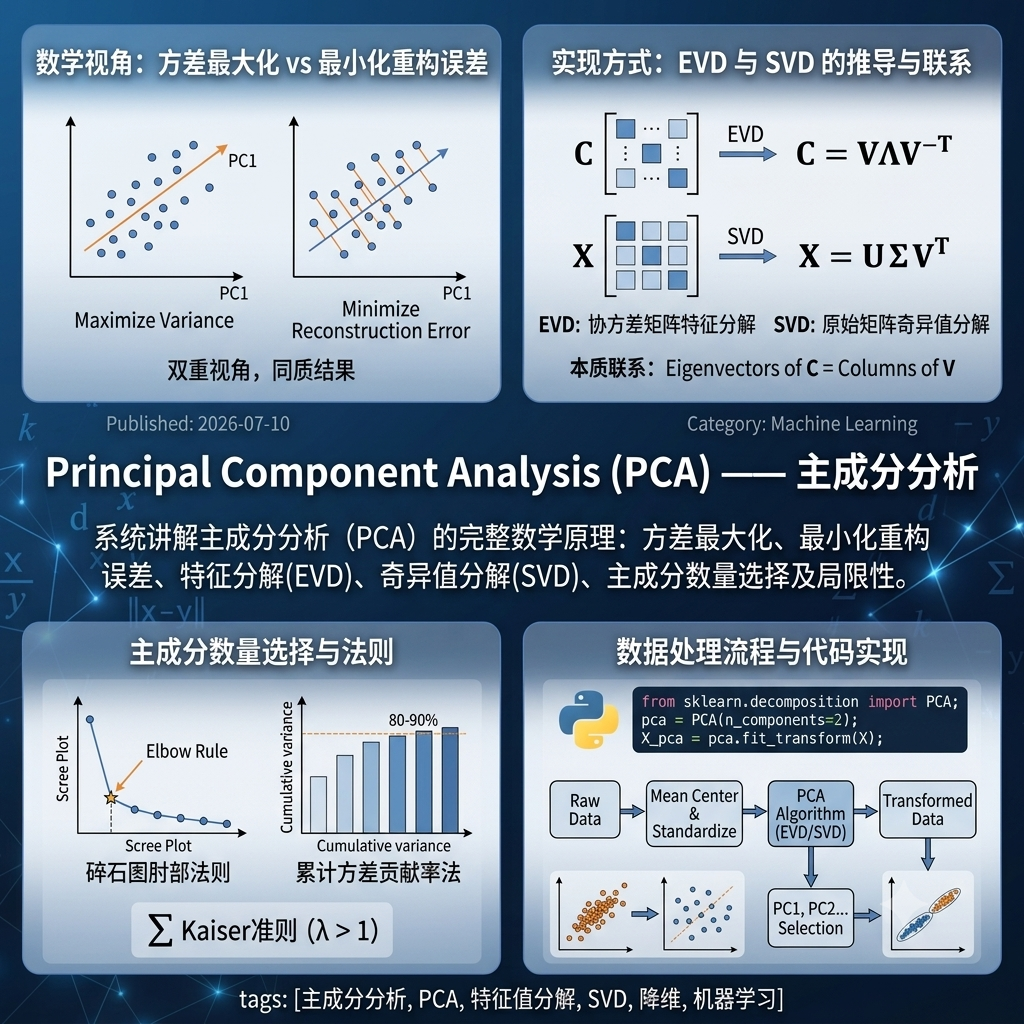
系统讲解主成分分析(PCA)的完整数学原理:从方差最大化与最小化重构误差两个等价视角出发,通过拉格朗日乘子法推导出协方差矩阵的特征方程,揭示特征向量即主成分方向、特征值即主成分方差的本质联系;深入对比EVD与SVD两种实现方式的优劣与适用场景;详细介绍三种主成分数量选择方法;讨论PCA的假设和局限。
阅读文章
系统解析XGBoost与LightGBM两大梯度提升框架的核心工程优化技术。涵盖XGBoost的二阶泰勒展开与正则化项的数学推导、预排序与Block并行架构;LightGBM的直方图算法、GOSS梯度采样、EFB互斥特征捆绑三大加速技术,以及Level-wise与Leaf-wise树生长策略的对比。
阅读文章
系统推导梯度提升机(GBM)的数学原理,从加法模型与前向分步算法出发,深入剖析“拟合负梯度”在函数空间梯度下降中的核心地位,通过偏差-方差分解对比GBM与随机森林的本质差异,并分析GBM对异常值敏感的根本原因及缓解策略(鲁棒损失函数、学习率、子采样)。
阅读文章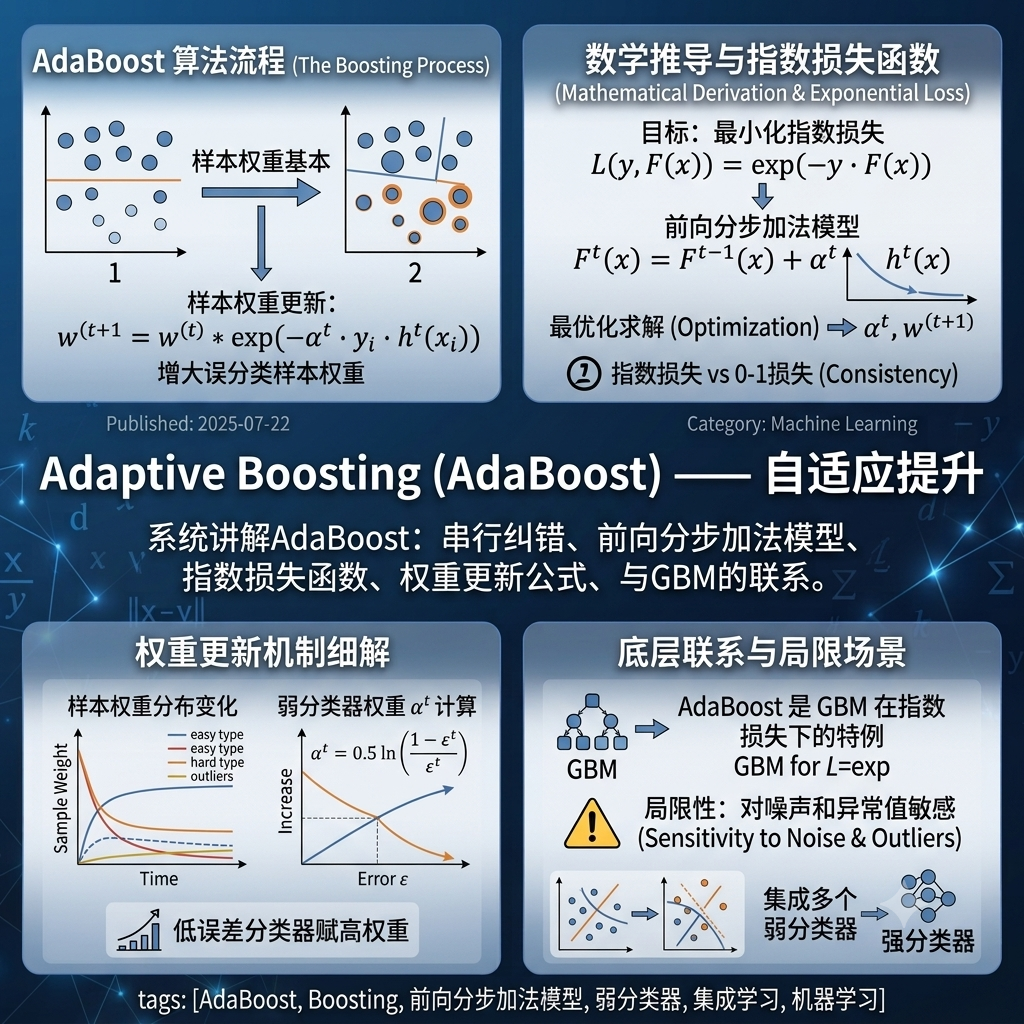
系统讲解AdaBoost算法的完整数学原理:从Boosting的串行纠错思想出发,推导前向分步加法模型与指数损失函数的等价性,通过最优化求解揭示弱分类器权重和样本权重更新公式的数学来源;深入分析指数损失与0-1损失的一致性及其对异常值的敏感性;阐明AdaBoost是GBM在指数损失下的特例这一底层联系。
阅读文章
系统讲解集成学习的核心思想,从Bootstrap自助采样的数学原理出发,深入剖析Bagging的方差降低机制、随机森林的双重随机性(行采样+列采样)、OOB误差的理论基础与实用价值,并对比基尼重要性与排列重要性两种特征重要性计算方法。
阅读文章
系统讲解决策树家族的三大经典算法(ID3、C4.5、CART)及其分裂准则的数学原理(信息增益、信息增益率、基尼指数、MSE),深入剖析预剪枝与后剪枝(CCP成本复杂度剪枝)的策略与权衡,并解释决策树对特征尺度不敏感的深层原因。
阅读文章
系统讲解核方法的数学原理与常用核函数的映射本质。涵盖核函数的定义、Mercer定理作为核方法的理论基石、核技巧将线性SVM对偶问题中的内积替换为核函数从而优雅处理非线性问题、多项式核的有限维映射与RBF(高斯)核的无穷维映射,以及RBF核中gamma参数对过拟合与欠拟合的影响与调优策略。
阅读文章
系统讲解支持向量机的完整数学推导与核心原理。涵盖函数间隔与几何间隔的定义及差异、硬间隔SVM的原始问题、拉格朗日对偶推导与KKT条件、软间隔SVM通过松弛变量与惩罚参数C处理线性不可分数据、Hinge Loss作为SVM损失函数的等价视角,以及SVM与逻辑回归在离群点鲁棒性上的本质差异。
阅读文章
系统讲解朴素贝叶斯的数学原理与三种分布假设(高斯、多项式、伯努利)的适用场景,深入剖析条件独立假设与拉普拉斯平滑的数学动机,对比生成式模型与判别式模型的本质差异,并揭示朴素贝叶斯在文本分类中表现出色的深层原因。
阅读文章
全面剖析 KNN 算法的核心机制、KD-Tree 与 Ball-Tree 的加速原理与适用场景,深入揭示维度灾难导致高维欧氏距离失效的数学根源,并强调特征标准化对 KNN 的必要性。
阅读文章
系统讲解逻辑回归与Softmax多分类的核心原理与完整数学推导。涵盖Sigmoid函数的概率映射与导数特性、对数几率与线性决策边界、最大似然估计推导二分类交叉熵损失及梯度下降求解、Softmax回归从二分类到多分类的自然推广、Log-Sum-Exp数值稳定性技巧,以及宏平均与微平均F1-Score在多分类评价中的适用场景与代码实现。
阅读文章
系统讲解线性回归模型的核心原理与演进路径,涵盖最小二乘法(OLS)的矩阵推导与正规方程、Ridge(L2)正则化的闭式解与收缩特性、Lasso(L1)正则化的稀疏性来源、ElasticNet 的组合优势,以及 MSE/RMSE/MAE 评价指标的适用场景与异常值敏感性对比。
阅读文章