



Lecture 1:Transformer background and architecture
系统梳理Transformer的诞生背景与核心架构,涵盖分词策略、词表示演进、RNN/LSTM的痛点、自注意力与多头注意力机制、位置编码、编码器-解码器设计,并通过机器翻译端到端案例串联NLP完整技术栈。
阅读文章
ZHY's Blog
A UNIVERSE OF IDEAS · BY ZHANG HAOYI
让好奇心 点亮知识宇宙
在代码、模型与思想之间自由漫游。这里持续记录人工智能、机器学习、软件工程与成长实践,让每次阅读都成为一次新的发现。


ARTICLE NOTE
本讲内容全部基于Transformer基础注意力机制展开,需先牢牢掌握缩放点积注意力和多头注意力的公式、原理及架构落地。
(1)核心公式:
:查询矩阵, 为序列长度, 为Q/K的维度,代表当前token的特征表示; :键矩阵, 为键值序列长度(自注意力中 ),代表所有token的特征表示; :值矩阵, 为V的维度(通常 ),是注意力权重的加权对象; :缩放因子,解决 过大时, 内积值爆炸导致softmax输出趋近于one-hot、梯度消失的问题; :对 的行向量做归一化,将注意力得分转化为0-1的权重,保证所有token的注意力权重和为1;
(2)核心逻辑:通过Q与K的相似度计算注意力权重,再用权重对V加权求和,实现对上下文的自适应关注。
(3)注意力得分与注意力图:
(1)实现步骤与公式
对Q/K/V做线性映射:通过 组独立的可学习权重矩阵 、 、 ,将原始特征(维度 )映射为 组低维Q/K/V:
每组独立计算缩放点积注意力:
拼接所有头的结果并做最终线性映射: 其中 为输出映射矩阵,将拼接后的特征还原为 维度。
(2)核心作用:将注意力机制拆分为 个独立的注意力头,每个头捕捉不同类型的上下文关联(如局部语义、长距离依赖、词法关联),拼接后实现特征的多维度融合,提升模型表达能力。
由编码器(Encoder)和解码器(Decoder)组成,均为Nx层堆叠,核心组件为「多头注意力 + 前馈网络(FFN) + 残差连接 + Add&Norm」,解码器额外包含掩码多头注意力(Masked MHA):
(1)实现思路:为每个位置 ( , 为训练时的最大序列长度)随机初始化一个位置嵌入向量 ,与词嵌入 相加作为模型输入:
(2)训练方式:位置嵌入向量随模型一起参与端到端训练,通过反向传播优化;
(3)核心局限性:无法扩展到训练时未见过的更长序列,若测试时序列长度超过 ,无对应的位置嵌入,需重新训练,灵活性极差。
(1)特点:无需训练,通过三角函数生成,解决可学习嵌入的扩展问题,是最经典的绝对位置编码。
(2)核心公式:
:token在序列中的绝对位置(从0或1开始计数); :位置嵌入向量的维度索引( ); :嵌入向量的总维度,通常为偶数(如512、768); :超参数,控制三角函数的周期范围,使位置编码的周期随维度增加呈指数级增长,捕捉不同尺度的位置信息。
(3)公式简化表示:令 ,则公式可简化为:
(4)优势:捕捉相对位置信息(核心);可扩展到任意长度的序列,无需重新训练,解决可学习嵌入的核心问题;三角函数的周期性使模型能捕捉序列的局部和全局位置规律。

图1 硬编码优势
通过三角函数差角公式推导,可证明两个位置嵌入的内积仅与相对位置有关):
- 差角公式: ;
- 代入位置编码:令 ,则:
- 内积推导:位置嵌入 和 的内积为各维度乘积之和,每一对 维度的乘积和为 ,因此 即内积结果仅为相对位置 的函数,模型可通过内积感知token间的相对距离。
硬编码嵌入本质是绝对位置编码,而自然语言中相对位置比绝对位置更重要。因此后续研究直接修改注意力层,让模型显式捕捉相对位置。
(1)核心思路:在缩放点积注意力的Q-K相似度得分中,添加一个仅与相对位置有关的偏置项,让注意力权重直接受相对位置影响。
(2)改进后注意力公式:
其中 为 的第 行(第 个token的查询向量), 为 的第 行(第 个token的键向量), 为位置 和 的偏置,仅由相对位置 决定。
(3)两种经典偏置实现:
T5 Bias:为每个注意力头学习分桶的偏置参数,将相对位置 划分为若干桶,同一桶内的相对位置共享一个偏置:
其中 为可学习参数,分桶策略可压缩参数数量,适配长序列。
ALiBi(Attention with Linear Biases):偏置为线性、确定性函数,无需学习,无边界限制,支持长序列外推:
其中 为注意力头专属的超参数(每个头一个 ),核心逻辑是让距离越近的token偏置越大,注意力权重越高,符合人类语言认知。
当前大语言模型(如LLaMA、GPT-4)的标配位置编码,无需添加嵌入向量,直接通过旋转矩阵将位置信息融入Q/K向量,完美捕捉相对位置。

图2 RoPE思想
(1)核心思路:对 的每一对二维特征,用与位置相关的旋转矩阵进行旋转,位置不同,旋转角度不同,最终让 的内积仅与相对位置有关。
(2)二维旋转矩阵:对位置 的token,其二维Q/K向量的旋转矩阵为:
其中 为旋转角度,与特征维度相关, (与硬编码嵌入的 一致)。
(3)高维扩展( ):将 维的Q/K向量按2维为一个块进行划分,每个块用独立的旋转矩阵 旋转,最终形成块对角旋转矩阵:
其中每个块的旋转矩阵为:
(4)核心性质: 的相似度仅由相对位置 决定,与绝对位置无关,完美实现相对位置编码。
其中 为原始token特征, 为Q/K的线性映射矩阵。
(5)优势:注意力权重随相对距离 增加自然衰减,符合人类语言的长距离依赖衰减规律;无需额外参数,计算效率高;支持任意长度的序列外推,无训练长度限制。
层归一化是Transformer训练的核心组件,解决内部协变量偏移(Internal Covariate Shift)问题,让模型训练更稳定、收敛更快。
(1)计算过程:给定一个 维特征向量 ,层归一化的计算过程为:
(2)特点:与批归一化(BN)不同,LN对每个样本的特征维度做归一化,而非对批次内的所有样本做归一化,因此不受批次大小影响,适配小批次训练;适用于NLP的序列数据,解决BN在序列任务中的局限性。
(3)作用:让每一层的输入分布保持稳定,避免因网络深度增加导致的特征分布漂移;缓解梯度消失/爆炸问题,加速模型收敛;提升模型的泛化能力。
Transformer中所有层都包含残差连接: (SubLayer为多头注意力或FFN),LN的位置决定了归一化的类型,按残差连接位置可划分为Post-Norm和Pre-Norm两种方案。
Pre-Norm解决了Post-Norm的深层训练问题,是目前所有Transformer类模型的默认选择。
(1)Post-Norm(后归一化)

图3 后归一化流程图
(2)Pre-Norm(前归一化)

图4 前归一化流程图
由《Root Mean Square Layer Normalization》提出,是Pre-Norm的轻量化改进版,移除了均值归一化,仅保留方差归一化,大幅减少计算量。
(1)核心公式:
(2)优势:移除均值计算,减少约50%的计算量,提升推理速度;保留LN的训练稳定性和收敛速度;无额外参数,仅保留缩放参数 。
(3)应用:GPT-3、LLaMA、Mistral等大语言模型均使用RMSNorm,是工业界的主流优化方案。
原始多头注意力为稠密注意力,计算复杂度为 ( 为序列长度),当 很大时,计算量和显存占用会呈平方级爆炸,无法训练和推理。因此采用两类注意力近似方法,核心是降低计算复杂度,适配长序列处理。
(1)核心思路:将稠密的全注意力矩阵改为稀疏矩阵,让每个token仅关注局部窗口内的token(局部注意力),同时为特殊token(如 [CLS] )保留全局注意力,兼顾局部语义和全局信息,计算复杂度降至 ( 为窗口大小,远小于 )。
(2)滑动窗口注意力(SWA, Sliding Window Attention)
(3)Longformer的稀疏注意力设计
(1)核心思路:在多头注意力中,共享Key/Value头,减少K/V的参数数量和计算量,仅保留Query头的多样性,是效率与效果的折中方案。
(2)原始多头注意力(MHA, Multi-Head Attention)
(3)多查询注意力(MQA, Multi-Query Attention)
(4)分组查询注意力(GQA, Group-Query Attention)

图5 注意力头共享
| 方案 | 分组数 | K/V头数 | 计算复杂度 | 效果 | 应用 |
|---|---|---|---|---|---|
| MHA | ★★★★★ | 小序列模型、追求效果 | |||
| GQA | ★★★★☆ | 大语言模型(GPT-3、LLaMA) | |||
| MQA | ★★★☆☆ | 低延迟推理、边缘设备 |
Transformer衍生模型可按编码器/解码器的组合方式分为三大类,分别适配不同的NLP任务,是理解所有大语言模型的基础框架,目前Decoder-only模型为绝对主流。
| 架构类型 | 核心组件 | 注意力类型 | 核心任务 | 代表模型 | 流行阶段 | 核心特点 |
|---|---|---|---|---|---|---|
| Encoder-Decoder(编解码器) | 编码器+解码器 | 编码器:双向自注意力;解码器:掩码自注意力+交叉注意力 | 文本到文本转换(机器翻译、摘要、改写、问答) | T5、mT5、ByT5、BART | 2017-2020 | 端到端文本转换,适配跨文本任务 |
| Encoder-only(仅编码器) | 仅编码器 | 双向自注意力 | 文本理解/分类(情感分析、命名实体识别、文本匹配) | BERT、DistilBERT、RoBERTa、ALBERT | 2018-2022 | 双向上下文理解,适合分类/识别任务,无生成能力 |
| Decoder-only(仅解码器) | 仅解码器 | 掩码自注意力 | 文本生成(续写、对话、创作、代码生成) | GPT系列、LLaMA、Mistral、Falcon | 2020-至今 | 自回归生成,适配所有生成任务,目前大语言模型主流 |
核心概念:交叉注意力(Cross-Attention)——仅存在于Encoder-Decoder架构中,解码器的交叉注意力层以解码器的Q为查询,以编码器的K/V为键值,让解码器关注源文本的上下文信息,是机器翻译、摘要等任务的核心。

图6 BERT整体架构
BERT(Bidirectional Encoder Representations from Transformers)是NLP发展的里程碑模型,开启了预训练+微调的范式。
(1)定义:BERT——Bidirectional Encoder Representations from Transformers(基于Transformer的双向编码器表示);
(2)架构:仅使用Transformer的编码器部分,堆叠多层双向自注意力;
(3)特点:真正的双向上下文理解,与Decoder-only模型的单向注意力形成本质区别(Decoder-only仅能关注前文,BERT可同时关注前文和后文);
(4)对比ELMo:ELMo(2018.2)是基于RNN的双向语言模型,属于特征基方法;BERT(2018.10)是基于Transformer的双向模型,属于微调基方法,性能远超ELMo,实现NLP任务的全面SOTA。
(1)核心逻辑:
(2)范式优势:
预训练的核心是无监督学习,通过代理任务让模型学习语言规律,BERT有两个核心代理任务:掩码语言模型(MLM)和下一句预测(NSP)。
(1)核心思路:随机遮蔽输入序列中15%的token,让模型根据上下文预测被遮蔽的token,强制模型学习双向上下文关联。
(2)遮蔽规则(关键设计,避免模型过拟合 标记):对选中的15%token,按以下概率处理:
(3)核心优势:让模型学习基于双向上下文的语义预测,而非简单的词袋模型;随机替换和不变的规则引入正则化,让模型更贴合真实语言场景,避免过度依赖 标记;覆盖词汇、语法、语义等多维度的语言知识。
(1)核心思路:从语料中选取两个句子A和B,构建句子对,让模型预测B是否为A的真实下一句,强制模型学习句子之间的语义关联。
(2)构建规则:
(3)核心优势:让模型学习句间的逻辑关系,适配问答、摘要、文本匹配等需要句间关联的任务;无监督任务,无需额外的人工标注;提升模型对长文本的理解能力。
BERT的输入需要经过严格的预处理,包括分词和特殊标记添加,是模型能处理各种任务的基础。
(1)分词算法:WordPiece
(2)输入序列的特殊标记:为适配MLM和NSP任务,BERT为输入序列添加4种特殊标记,规则固定:
输入序列示例:
- 单句输入(情感分析): this teddy bear is so cute …
- 句子对输入(NSP/问答): what is a teddy bear it is a cute toy …
BERT的输入嵌入由三部分向量相加组成,最终得到位置和段感知的嵌入向量,维度均为 (BERT-Base),是模型的输入层核心。
(1) 词嵌入(Word Embedding)
(2)位置编码(Positional Encoding)
(3)段嵌入(Segment Encoding)
(4)核心特点:三嵌入逐元素相加,而非拼接,保证嵌入维度不变,同时融合词汇、位置、段三种信息,为后续的编码器提供丰富的输入特征。
BERT的模型规模由三层超参数决定:编码器层数 、隐藏层维度 、注意力头数 。6种不同规模的BERT模型,参数数量从4M到340M不等,BERT-Base和BERT-Large为实际应用中的主流版本。
| 模型版本 | 编码器层数 | 隐藏层维度 | 注意力头数 | 总参数数量 | 适用场景 |
|---|---|---|---|---|---|
| BERT-Tiny | 2 | 128 | 2 | 4M | 边缘设备、低延迟推理 |
| BERT-Mini | 4 | 256 | 4 | 11M | 轻量级任务、快速验证 |
| BERT-Small | 4 | 512 | 8 | 30M | 中等规模任务、平衡效率与效果 |
| BERT-Medium | 8 | 512 | 8 | 42M | 中等规模任务、提升效果 |
| BERT-Base | 12 | 768 | 12 | 110M | 工业界主流、大部分NLP任务 |
| BERT-Large | 24 | 1024 | 16 | 340M | 追求SOTA效果、大算力场景 |
超参数设计规律
- 注意力头数 与隐藏层维度 满足: ( 为每个注意力头的维度,通常为64),如BERT-Base中 ;
- 模型参数主要集中在嵌入层和编码器的线性层/注意力层,层数越多、维度越大,模型的表达能力越强,但计算量和显存占用呈指数级增长。
微调是BERT适配下游任务的核心步骤,以情感分析(积极/消极分类)为例阐述BERT微调的全流程,该流程可通用到所有序列分类任务(如文本分类、情感分析、文本匹配)。
(1)核心步骤(共6步)

图7 BERT微调流程
输入构造:在情感分析句子前添加 ,末尾添加 ,用 补全到固定长度(如512),得到标准输入序列:
嵌入层计算:计算词嵌入+位置编码+段嵌入,得到三嵌入相加的输入特征向量,维度为 ( 为序列长度);
编码器编码:将输入特征向量送入预训练的BERT编码器,经过12层(BERT-Base)双向自注意力和FFN的处理,得到所有token的隐藏层表示,维度为 ;
聚合序列特征:取 标记对应的隐藏层表示 ,作为整个序列的聚合特征,该特征融合了整个句子的双向上下文信息;
分类层设计:在 后添加一个简单的前馈网络(FFN),作为任务专属的分类层:
其中 、 为分类层的可学习参数,2为情感分析的类别数(积极/消极);
微调训练:冻结BERT编码器的大部分权重(可选择冻结前 层,仅微调后2层);仅训练分类层和编码器顶层的少量权重;使用交叉熵损失作为损失函数,用小批量有标注数据进行端到端训练。
(2)核心技巧
(1)核心优势
(2)主要局限性
为解决原始BERT的局限性,研究者提出了多种BERT变体,如高效型变体DistilBERT和性能型变体RoBERTa,分别从效率和性能两个维度优化BERT。
(1)核心思路:基于知识蒸馏(Knowledge Distillation),将大模型(教师模型,BERT-Base)的知识迁移到小模型(学生模型,DistilBERT),在保证性能的前提下,大幅减少模型参数量和计算量。
(2)核心损失:蒸馏损失由硬损失和软损失两部分组成,总损失为:
:交叉熵损失,学生模型的预测 与真实标签 的损失(硬损失); :KL散度损失,学生模型的预测 与教师模型的预测 的损失(软损失),核心公式: :超参数,平衡硬损失和软损失(通常取0.5)。
(3)模型设计:
(4)性能效率:参数量从110M减少为66M,减少约40%;推理速度提升约1.6倍;保留BERT-Base约97%的下游任务性能。
(1)核心思路:不改变BERT的模型架构,仅对预训练过程进行全面优化,提升模型的性能,是目前最常用的BERT变体,性能远超原始BERT。
(2)核心优化点
(3)性能效率:在所有NLP基准数据集(GLUE、SQuAD、MNLI)上,RoBERTa相比原始BERT性能提升4%以上,且模型架构完全一致,仅通过预训练优化实现。
(4)核心结论:BERT的性能瓶颈并非架构,而是预训练数据量、训练策略和掩码方式,这为后续大语言模型的预训练优化提供了重要思路。
Note总结
- 位置编码是Transformer的核心组件,从绝对位置编码(可学习/硬编码)发展到相对位置编码(RoPE为主流),实现了模型对相对位置的显式捕捉,是长序列模型的基础;
- 层归一化的发展趋势为Post-Norm→Pre-Norm→RMSNorm,核心是提升训练稳定性和计算效率,RMSNorm成为大语言模型的标配;
- 注意力近似方法(稀疏注意力+注意力头共享)是长序列处理的关键,通过降低计算复杂度,让Transformer能处理万级以上的长序列;
- Transformer模型分为Encoder-Decoder、Encoder-only、Decoder-only三类,Decoder-only模型因自回归生成能力成为目前大语言模型的绝对主流;
- BERT是Encoder-only模型的代表,开启了NLP的预训练+微调范式,其变体DistilBERT(效率)和RoBERTa(性能)分别从不同维度优化了BERT,成为工业界的主流模型;
- 大语言模型的核心优化方向为预训练数据量、训练策略、注意力机制和位置编码,架构上的创新远不如训练策略的优化带来的性能提升显著。
按顺序完成这组文章,循序渐进地掌握主题
发现错误、内容过时或有改进想法?欢迎告诉我
根据本文分类与标签,为你推荐可能感兴趣的内容
系统梳理Transformer的诞生背景与核心架构,涵盖分词策略、词表示演进、RNN/LSTM的痛点、自注意力与多头注意力机制、位置编码、编码器-解码器设计,并通过机器翻译端到端案例串联NLP完整技术栈。
阅读文章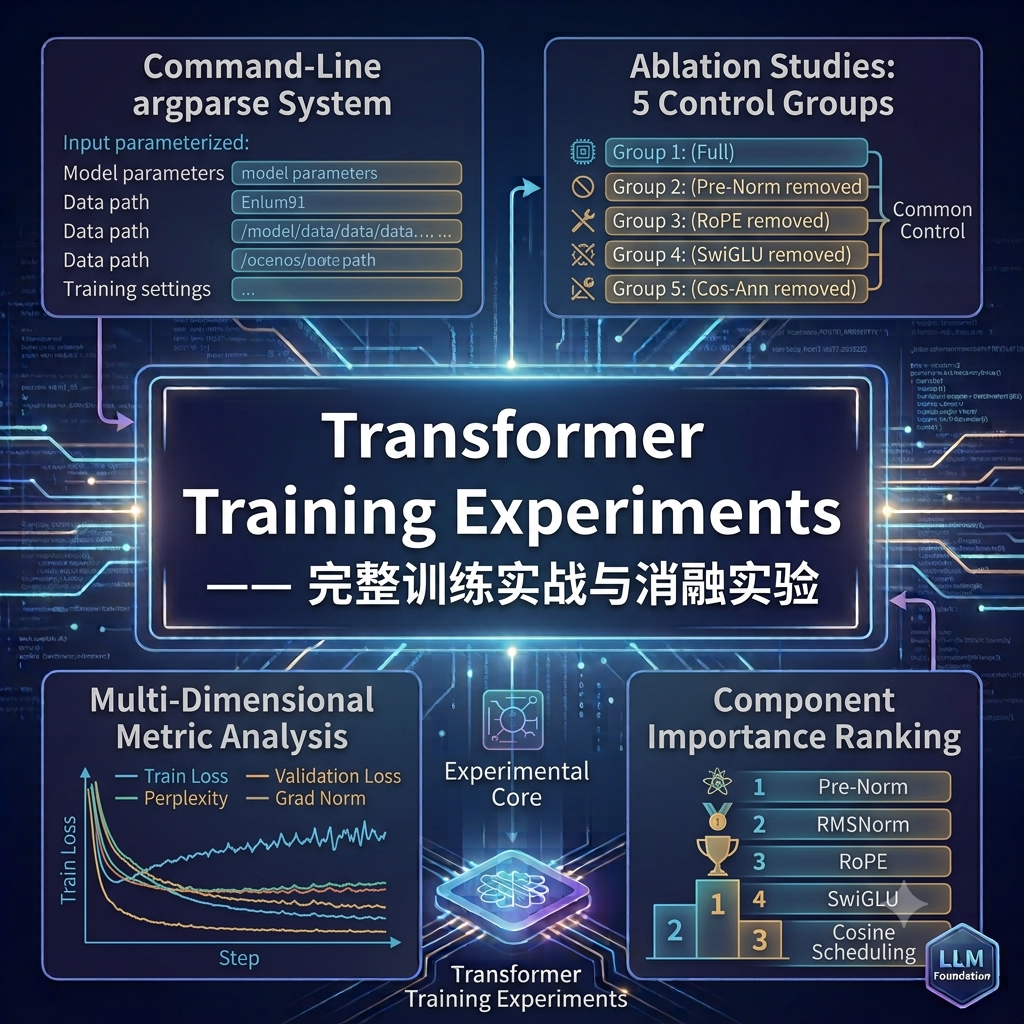
系统讲解基于argparse的命令行训练脚本设计与五组消融实验的科学验证:从高度参数化的训练框架出发,设计五组对照实验以量化各组件贡献;基于训练损失/验证损失/困惑度/梯度范数等多维度指标分析,得出各组件重要性排序;展示完整的训练循环实现及自动化批量实验的工程价值。附有完整命令行参数体系与实验配置。
阅读文章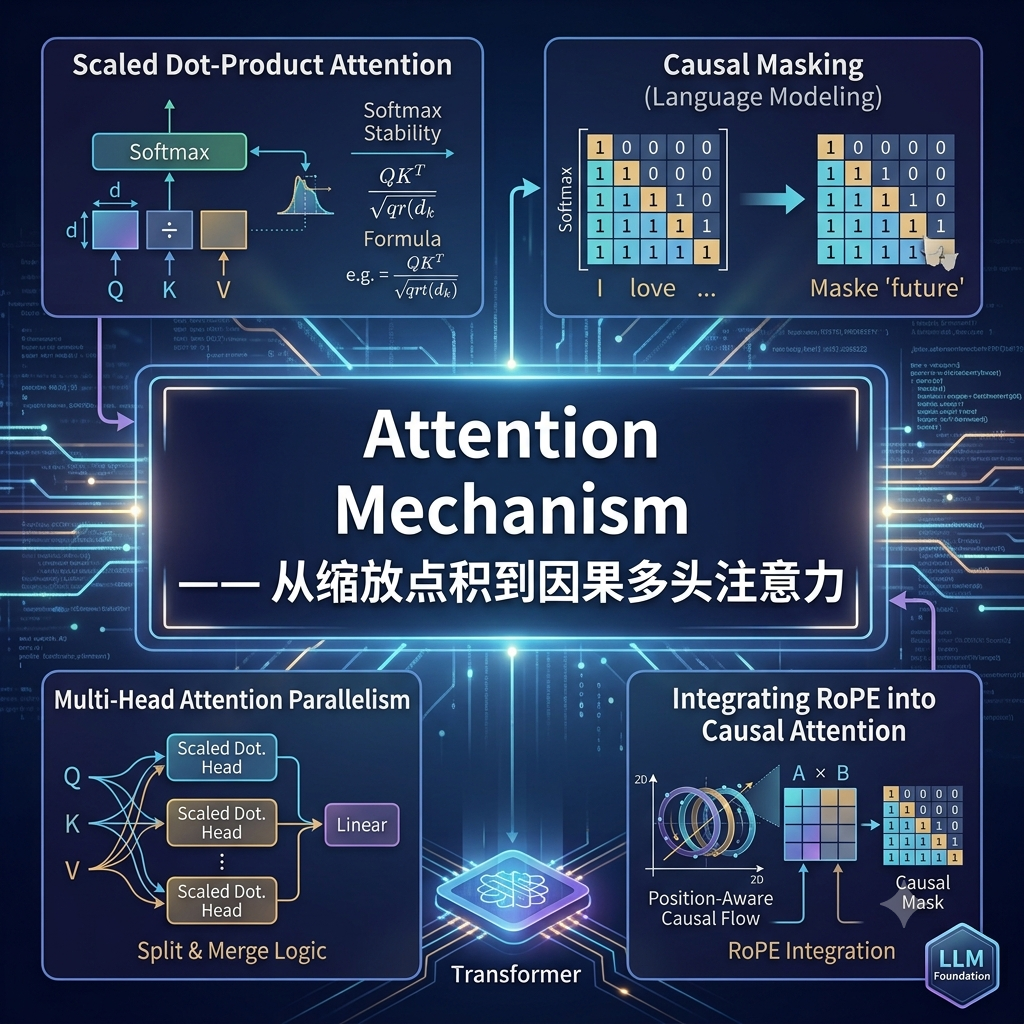
系统讲解Transformer注意力机制的核心原理与完整实现:从数值稳定的Softmax出发,推导缩放点积注意力的数学公式与几何意义;深入剖析因果掩码的下三角矩阵机制及其在自回归语言模型中的关键作用;详解多头注意力的拆分与合并逻辑及并行计算优势;最后阐述RoPE旋转位置编码如何直接融入注意力计算,与因果掩码协同实现带位置感知的因果注意力。
阅读文章请使用微信扫描二维码分享
当前文章会保持在原页面