


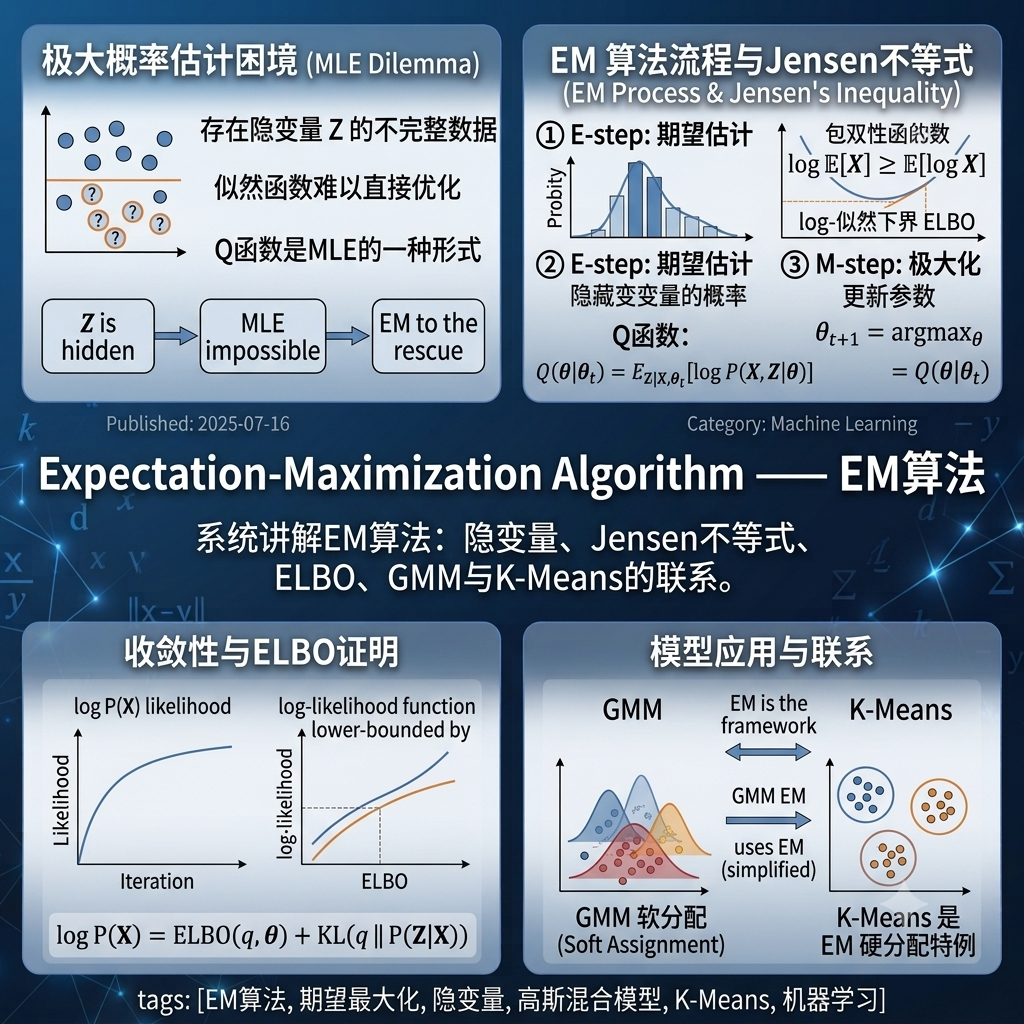
Expectation-Maximization Algorithm —— EM算法
系统讲解期望最大化(EM)算法的完整数学原理:从极大似然估计在隐变量存在时的困境出发,推导E步与M步的迭代框架;基于Jensen不等式证明ELBO证据下界与收敛性;通过二硬币模型与高斯混合模型(GMM)两个完整实例展示EM的具体计算流程;揭示K-Means是EM在硬分配下的特例这一深层联系。
阅读文章
ZHY's Blog
A UNIVERSE OF IDEAS · BY ZHANG HAOYI
让好奇心 点亮知识宇宙
在代码、模型与思想之间自由漫游。这里持续记录人工智能、机器学习、软件工程与成长实践,让每次阅读都成为一次新的发现。


ARTICLE NOTE
上一篇文章中,我们系统推导了 EM 算法的完整数学框架——它通过“E 步计算隐变量后验、M 步最大化期望似然”的迭代策略,为含隐变量的概率模型提供了通用的参数估计方法论。EM 算法是一个“框架”,而非具体模型。现在,我们将走进这个框架最经典、最具影响力的具体实现之一 —— 隐马尔可夫模型(Hidden Markov Model, HMM)。
HMM 所面对的数据与前面所有模型都不同。线性回归、逻辑回归、SVM、决策树乃至 GMM,处理的都是独立同分布的样本 —— 样本之间没有顺序依赖。但现实世界中大量数据是以序列形式存在的:语音是一串声学帧,文本是一串单词,DNA 是一串碱基。这些序列的共同特征在于时序依赖 —— 当前位置的状态与前一位置的状态密切相关。HMM 正是为捕捉这种依赖而设计的双重随机过程:底层是一个不可观测的马尔可夫链(状态随时间转移),上层是在每个状态下生成观测值的发射过程。
本文将从 HMM 的五元组参数 出发,系统讲解其三大核心问题及对应的经典算法:估值问题(前向算法,计算观测序列概率)、解码问题(维特比算法,推断最优隐藏状态序列)、学习问题(Baum-Welch 算法,即 EM 在 HMM 中的具体实现)。这三个问题覆盖了从“已知模型做推断”到“从数据中学习模型”的完整链路,也是语音识别、词性标注、中文分词等应用的算法基石。
Note至此,我们走完了本系列 15 篇文章的完整旅程——从线性回归的解析基石出发,历经逻辑回归、KNN、朴素贝叶斯的判别与生成范式,SVM 与核技巧的几何极致,决策树与集成学习的树模型家族(随机森林、AdaBoost、GBM、XGBoost、LightGBM),再到无监督与概率模型的降维(PCA)、聚类(K-Means)、隐变量推断(EM)与时序建模(HMM)。
这条路径从“有标签”走向“无标签”,从“独立同分布”走向“时序依赖”,从“参数化假设”走向“非参数灵活”,构建了一个覆盖机器学习核心领域的全景认知框架。
在进入HMM之前,先回顾一下马尔可夫链(Markov Chain) 。
马尔可夫链描述的是一个状态序列,其中每个状态都直接可见。它的核心假设是马尔可夫性(Markov Property):未来状态只依赖于当前状态,与过去无关。
用数学语言表达:
一个马尔可夫链由三个要素决定:
HMM在马尔可夫链的基础上增加了一个层次:状态本身是不可见的(隐藏的) ,只能观察到与状态相关的观测值。
HMM是一个双重随机过程:
一个经典的例子:天气与海藻。我们看不见天气(隐藏状态:晴天、多云、雨天),但能看见海藻的湿度(观测值:干、湿润、潮湿)。海藻的湿度由当天的天气决定。
一个HMM由五个要素构成:
其中:
隐藏状态集合 —— 所有可能的状态。 是状态的数量。
观测集合 —— 所有可能的观测值。 是观测值的数量。注意状态数 和观测数 不一定相等。
初始状态概率分布 —— ,表示在初始时刻 时处于状态 的概率。
状态转移概率矩阵 —— ,表示从状态 转移到状态 的概率。每一行之和为1:。
观测概率矩阵(发射概率) —— ,表示在状态 下观测到 的概率。每一行之和为1:。
HMM生成一个观测序列的过程如下:
代码实现:
import numpy as np
class HMM: """隐马尔可夫模型的基础类"""
def __init__(self, n_states, n_obs): """ n_states: 隐藏状态数量 N n_obs: 观测值数量 M """ self.n_states = n_states self.n_obs = n_obs
# 初始化参数(随机) self.pi = np.ones(n_states) / n_states # 初始状态分布 self.A = np.ones((n_states, n_states)) / n_states # 转移矩阵 self.B = np.ones((n_states, n_obs)) / n_obs # 发射矩阵
def generate(self, T): """生成一个长度为T的观测序列""" states = np.zeros(T, dtype=int) observations = np.zeros(T, dtype=int)
# 步骤1:选择初始状态 states[0] = np.random.choice(self.n_states, p=self.pi) # 步骤2:生成第一个观测 observations[0] = np.random.choice(self.n_obs, p=self.B[states[0]])
# 步骤3-4:迭代生成 for t in range(1, T): states[t] = np.random.choice(self.n_states, p=self.A[states[t-1]]) observations[t] = np.random.choice(self.n_obs, p=self.B[states[t]])
return states, observations
# 示例:创建一个简单的HMM并生成序列hmm = HMM(n_states=3, n_obs=4)states, obs = hmm.generate(T=10)print(f"隐藏状态序列: {states}")print(f"观测序列: {obs}")HMM有三个经典问题,覆盖了从“已知模型做推断”到“从数据中学习模型”的完整链路。
问题描述:给定模型 和观测序列 ,计算观测序列出现的概率 。
应用场景:语音识别中,有多个HMM模型(每个词一个模型),给定一段语音信号(观测序列),计算它在每个模型下的概率,概率最大的模型对应的词就是识别结果。
解决算法:
1. 直接计算法(不可行)
最朴素的想法是穷举所有可能的状态序列 ,计算联合概率再求和:
但时间复杂度是 —— 状态数 的 次方,完全不可行。
2. 前向算法(Forward Algorithm)
前向算法用动态规划将复杂度降到 。
定义前向变量 :在时刻 ,隐藏状态为 ,且观测到 的联合概率:
初始化():
递推():
终止:
代码实现:
def forward(self, obs): """前向算法:计算 P(O | lambda)""" T = len(obs) alpha = np.zeros((T, self.n_states))
# 初始化 for i in range(self.n_states): alpha[0, i] = self.pi[i] * self.B[i, obs[0]]
# 递推 for t in range(1, T): for j in range(self.n_states): alpha[t, j] = np.sum(alpha[t-1, :] * self.A[:, j]) * self.B[j, obs[t]]
# 终止 return np.sum(alpha[T-1, :])
# 将方法添加到HMM类中HMM.forward = forward
# 测试hmm = HMM(n_states=3, n_obs=4)# 设置已知参数(便于验证)hmm.pi = np.array([0.5, 0.3, 0.2])hmm.A = np.array([[0.5, 0.3, 0.2], [0.2, 0.5, 0.3], [0.3, 0.2, 0.5]])hmm.B = np.array([[0.5, 0.3, 0.1, 0.1], [0.1, 0.4, 0.3, 0.2], [0.2, 0.2, 0.3, 0.3]])obs = [0, 2, 1, 3]prob = hmm.forward(obs)print(f"观测序列 {obs} 的概率: {prob:.6f}")3. 后向算法(Backward Algorithm)
后向算法是从后往前递推。
定义后向变量 :在时刻 状态为 的条件下,观测到 的概率:
初始化():
递推():
终止:
前向和后向算法可以结合使用,在Baum-Welch算法中两者缺一不可。
代码实现:
def backward(self, obs): """后向算法""" T = len(obs) beta = np.zeros((T, self.n_states))
# 初始化 beta[T-1, :] = 1
# 递推(从后往前) for t in range(T-2, -1, -1): for i in range(self.n_states): beta[t, i] = np.sum(self.A[i, :] * self.B[:, obs[t+1]] * beta[t+1, :])
# 终止 return np.sum(self.pi * self.B[:, obs[0]] * beta[0, :])
HMM.backward = backward问题描述:给定模型 和观测序列 ,找到最有可能产生该观测序列的隐藏状态序列 。
应用场景:词性标注中,给定一个句子(观测序列是单词),找出每个单词最可能的词性(隐藏状态是词性标签)。
解决算法:
1. 维特比算法(Viterbi Algorithm)
维特比算法是动态规划在HMM解码问题上的经典应用。它的核心思想是在时刻 到达状态 的所有路径中,只保留概率最大的一条——因为最优的全局路径一定由局部最优路径组成。
定义 :在时刻 ,到达状态 的所有路径中,概率最大的那条路径的概率:
同时定义 :记录到达状态 的最优路径中,前一时刻的状态是什么(用于回溯)。
初始化():
递推():
终止:
回溯(从 到 ):
代码实现:
def viterbi(self, obs): """维特比算法:解码最可能的隐藏状态序列""" T = len(obs) delta = np.zeros((T, self.n_states)) psi = np.zeros((T, self.n_states), dtype=int)
# 初始化 for i in range(self.n_states): delta[0, i] = self.pi[i] * self.B[i, obs[0]] psi[0, i] = 0
# 递推 for t in range(1, T): for j in range(self.n_states): # 找到使 delta[t-1][i] * A[i][j] 最大的 i max_prob = -1 max_idx = 0 for i in range(self.n_states): prob = delta[t-1, i] * self.A[i, j] if prob > max_prob: max_prob = prob max_idx = i delta[t, j] = max_prob * self.B[j, obs[t]] psi[t, j] = max_idx
# 终止 best_last_state = np.argmax(delta[T-1, :]) best_path = [best_last_state]
# 回溯 for t in range(T-1, 0, -1): best_path.insert(0, psi[t, best_path[0]])
return best_path
HMM.viterbi = viterbi
# 测试维特比算法obs = [0, 2, 1, 3]best_states = hmm.viterbi(obs)print(f"观测序列: {obs}")print(f"最可能的状态序列: {best_states}")问题描述:给定观测序列 (或多个观测序列),估计模型参数 ,使得 最大。
应用场景:用大量已标注或未标注的语料,训练一个HMM用于词性标注。
解决算法:
1. 有监督学习:极大似然估计
如果训练数据中既有观测序列,也有对应的隐藏状态序列(即有标注数据),学习问题很简单 —— 直接用频率估计概率:
2. 无监督学习:Baum-Welch算法(EM在HMM中的实现)
但在大多数情况下,我们只有观测序列,没有隐藏状态序列。这就是EM算法大显身手的地方——Baum-Welch算法正是EM算法在HMM中的具体实现。
Baum-Welch算法通过迭代的方式,在E步“猜测”隐藏状态,在M步更新模型参数。
E步:计算期望
利用前向变量 和后向变量 ,定义两个关键的期望统计量:
:在时刻 处于状态 的概率(给定整个观测序列):
:在时刻 处于状态 、时刻 处于状态 的概率:
M步:最大化更新参数
有了这些期望统计量,就可以更新模型参数:
代码实现:
def baum_welch(self, obs, n_iter=100, tol=1e-6): """ Baum-Welch算法:无监督学习HMM参数 这是EM算法在HMM中的具体实现 """ T = len(obs)
for iteration in range(n_iter): # ---- E步:计算前向和后向概率 ---- # 前向 alpha = np.zeros((T, self.n_states)) for i in range(self.n_states): alpha[0, i] = self.pi[i] * self.B[i, obs[0]] for t in range(1, T): for j in range(self.n_states): alpha[t, j] = np.sum(alpha[t-1, :] * self.A[:, j]) * self.B[j, obs[t]]
# 后向 beta = np.zeros((T, self.n_states)) beta[T-1, :] = 1 for t in range(T-2, -1, -1): for i in range(self.n_states): beta[t, i] = np.sum(self.A[i, :] * self.B[:, obs[t+1]] * beta[t+1, :])
# 计算gamma和xi gamma = np.zeros((T, self.n_states)) xi = np.zeros((T-1, self.n_states, self.n_states))
for t in range(T): denominator = np.sum(alpha[t, :] * beta[t, :]) for i in range(self.n_states): gamma[t, i] = alpha[t, i] * beta[t, i] / denominator
for t in range(T-1): denominator = 0 for i in range(self.n_states): for j in range(self.n_states): denominator += alpha[t, i] * self.A[i, j] * self.B[j, obs[t+1]] * beta[t+1, j] for i in range(self.n_states): for j in range(self.n_states): xi[t, i, j] = (alpha[t, i] * self.A[i, j] * self.B[j, obs[t+1]] * beta[t+1, j]) / denominator
# ---- M步:更新参数 ---- # 更新pi pi_new = gamma[0, :]
# 更新A A_new = np.zeros((self.n_states, self.n_states)) for i in range(self.n_states): for j in range(self.n_states): numerator = np.sum(xi[:, i, j]) denominator = np.sum(gamma[:-1, i]) A_new[i, j] = numerator / denominator if denominator > 0 else 0
# 更新B B_new = np.zeros((self.n_states, self.n_obs)) for j in range(self.n_states): for k in range(self.n_obs): numerator = np.sum(gamma[t, j] for t in range(T) if obs[t] == k) denominator = np.sum(gamma[:, j]) B_new[j, k] = numerator / denominator if denominator > 0 else 0
# 检查收敛 if (np.max(np.abs(self.pi - pi_new)) < tol and np.max(np.abs(self.A - A_new)) < tol and np.max(np.abs(self.B - B_new)) < tol): print(f"Baum-Welch收敛于第 {iteration+1} 轮迭代") break
self.pi, self.A, self.B = pi_new, A_new, B_new
return self
HMM.baum_welch = baum_welch
# 测试:从一个随机HMM生成数据,然后用Baum-Welch恢复参数true_hmm = HMM(n_states=3, n_obs=4)true_hmm.pi = np.array([0.6, 0.3, 0.1])true_hmm.A = np.array([[0.6, 0.3, 0.1], [0.2, 0.6, 0.2], [0.1, 0.3, 0.6]])true_hmm.B = np.array([[0.5, 0.3, 0.1, 0.1], [0.1, 0.5, 0.3, 0.1], [0.1, 0.1, 0.4, 0.4]])
# 生成观测序列_, obs_seq = true_hmm.generate(T=500)
# 用Baum-Welch学习(从随机初始化开始)learnt_hmm = HMM(n_states=3, n_obs=4)learnt_hmm.baum_welch(obs_seq, n_iter=50)
print("\n学习后的参数与真实参数的对比:")print(f"真实 pi: {true_hmm.pi}")print(f"学习 pi: {learnt_hmm.pi}")词性标注是HMM在NLP中最经典的应用之一。
问题设定:
给定一个句子 ,用维特比算法找到最可能的词性序列 。
HMM最早和最成功的应用领域就是语音识别。
问题设定:
HMM之所以在语音识别中如此成功,是因为语音信号具有时序特性 —— 前后帧之间存在依赖关系,而HMM天然适合建模这种依赖。
import numpy as npimport matplotlib.pyplot as plt
# 创建一个天气-海藻的HMM示例# 隐藏状态:0=晴天, 1=多云, 2=雨天# 观测值:0=海藻干, 1=海藻湿润, 2=海藻潮湿
weather_hmm = HMM(n_states=3, n_obs=3)
# 初始状态分布:假设第一天天气不确定weather_hmm.pi = np.array([0.4, 0.3, 0.3])
# 状态转移矩阵:天气变化规律weather_hmm.A = np.array([ [0.6, 0.3, 0.1], # 晴天 -> 晴天0.6, 多云0.3, 雨天0.1 [0.3, 0.4, 0.3], # 多云 -> 晴天0.3, 多云0.4, 雨天0.3 [0.1, 0.3, 0.6] # 雨天 -> 晴天0.1, 多云0.3, 雨天0.6])
# 发射概率矩阵:不同天气下海藻的湿度weather_hmm.B = np.array([ [0.7, 0.2, 0.1], # 晴天:干0.7, 湿润0.2, 潮湿0.1 [0.2, 0.6, 0.2], # 多云:干0.2, 湿润0.6, 潮湿0.2 [0.1, 0.3, 0.6] # 雨天:干0.1, 湿润0.3, 潮湿0.6])
# 观测序列:连续5天的海藻湿度观测值obs_sequence = [0, 1, 2, 1, 0] # 干, 湿润, 潮湿, 湿润, 干
# 1. 估值问题:计算观测序列的概率prob = weather_hmm.forward(obs_sequence)print(f"观测序列 {obs_sequence} 的概率: {prob:.6f}")
# 2. 解码问题:推断最可能的天气序列best_weather = weather_hmm.viterbi(obs_sequence)weather_names = ['晴天', '多云', '雨天']print(f"观测序列: {obs_sequence}")print(f"最可能的天气序列: {[weather_names[s] for s in best_weather]}")
# 3. 学习问题:从观测序列中学习参数# 生成更多数据用于训练_, train_obs = weather_hmm.generate(T=1000)
learnt_hmm = HMM(n_states=3, n_obs=3)learnt_hmm.baum_welch(train_obs, n_iter=30)
print("\n学习前后的参数对比(部分):")print(f"真实转移矩阵:\n{weather_hmm.A}")print(f"学习转移矩阵:\n{learnt_hmm.A}")总结
概念 核心内容 HMM五元组 :状态集、观测集、初始分布、转移矩阵、发射矩阵 估值问题 计算 ,用前向算法()代替直接计算() 解码问题 找最可能的状态序列 ,用维特比算法(动态规划) 学习问题 从观测序列估计参数,Baum-Welch算法 = EM算法在HMM中的实现 Baum-Welch E步:计算 和 ;M步:更新 核心假设 一阶马尔可夫性(状态只依赖前一时刻)+ 观测独立性(观测只依赖当前状态) 核心要点回顾
- HMM是一个双重随机过程:底层是看不见的马尔可夫链(状态转移),上层是根据状态生成观测值的过程(发射)。五元组 完整描述了这个模型。
- 三大核心问题覆盖了HMM的全部使用场景:估值(前向算法)计算观测序列的概率,用于模型匹配;解码(维特比算法)推断最可能的状态序列,用于序列标注;学习(Baum-Welch算法)从数据中估计参数,用于模型训练。
- 前向算法用动态规划将估值问题的复杂度从 降到 。后向算法是从后往前递推,两者结合使用可以计算各种期望统计量。
- 维特比算法是动态规划在解码问题上的经典应用,通过“保留到达每个状态的最优路径”来高效地找到全局最优状态序列。
- Baum-Welch算法是EM算法在HMM中的具体实现。E步用前向后向算法计算隐状态的期望( 和 ),M步用这些期望更新参数。它保证每一步都提升似然函数,但只能收敛到局部最优。
- HMM的假设是两个“朴素”但实用的假设:一阶马尔可夫性(未来只依赖当前)和观测独立性(观测只依赖当前状态)。这些假设虽然简化了模型,但在语音识别、词性标注等任务中效果极好。
按顺序完成这组文章,循序渐进地掌握主题
发现错误、内容过时或有改进想法?欢迎告诉我
根据本文分类与标签,为你推荐可能感兴趣的内容
系统讲解期望最大化(EM)算法的完整数学原理:从极大似然估计在隐变量存在时的困境出发,推导E步与M步的迭代框架;基于Jensen不等式证明ELBO证据下界与收敛性;通过二硬币模型与高斯混合模型(GMM)两个完整实例展示EM的具体计算流程;揭示K-Means是EM在硬分配下的特例这一深层联系。
阅读文章
系统讲解K-Means聚类的核心原理与算法细节,涵盖Lloyd交替优化算法的收敛性分析、K-Means作为EM算法特例的理论联系(硬分配 vs 软分配)、K-Means++初始化策略的D²采样机制与O(log K)近似保证,以及肘部法则与轮廓系数的选择K值方法及其局限。
阅读文章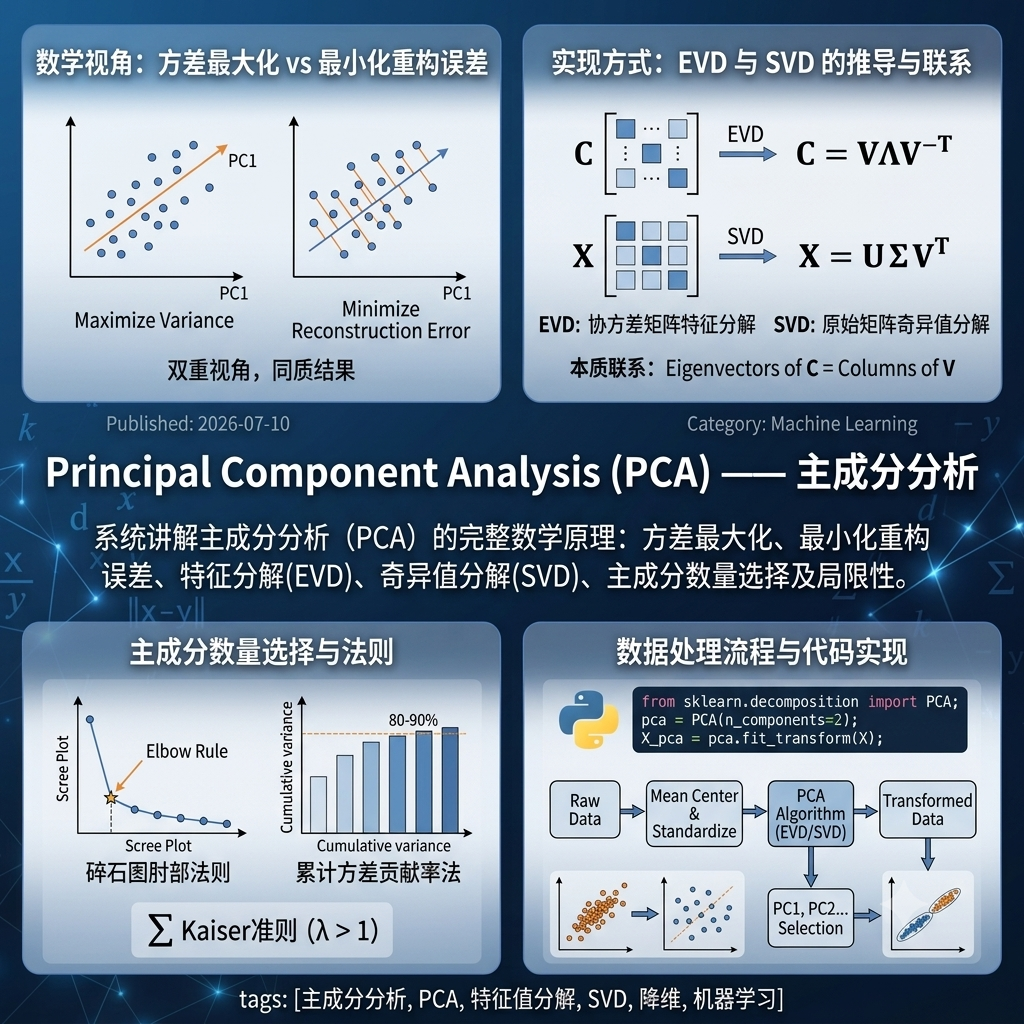
系统讲解主成分分析(PCA)的完整数学原理:从方差最大化与最小化重构误差两个等价视角出发,通过拉格朗日乘子法推导出协方差矩阵的特征方程,揭示特征向量即主成分方向、特征值即主成分方差的本质联系;深入对比EVD与SVD两种实现方式的优劣与适用场景;详细介绍三种主成分数量选择方法;讨论PCA的假设和局限。
阅读文章请使用微信扫描二维码分享
当前文章会保持在原页面