


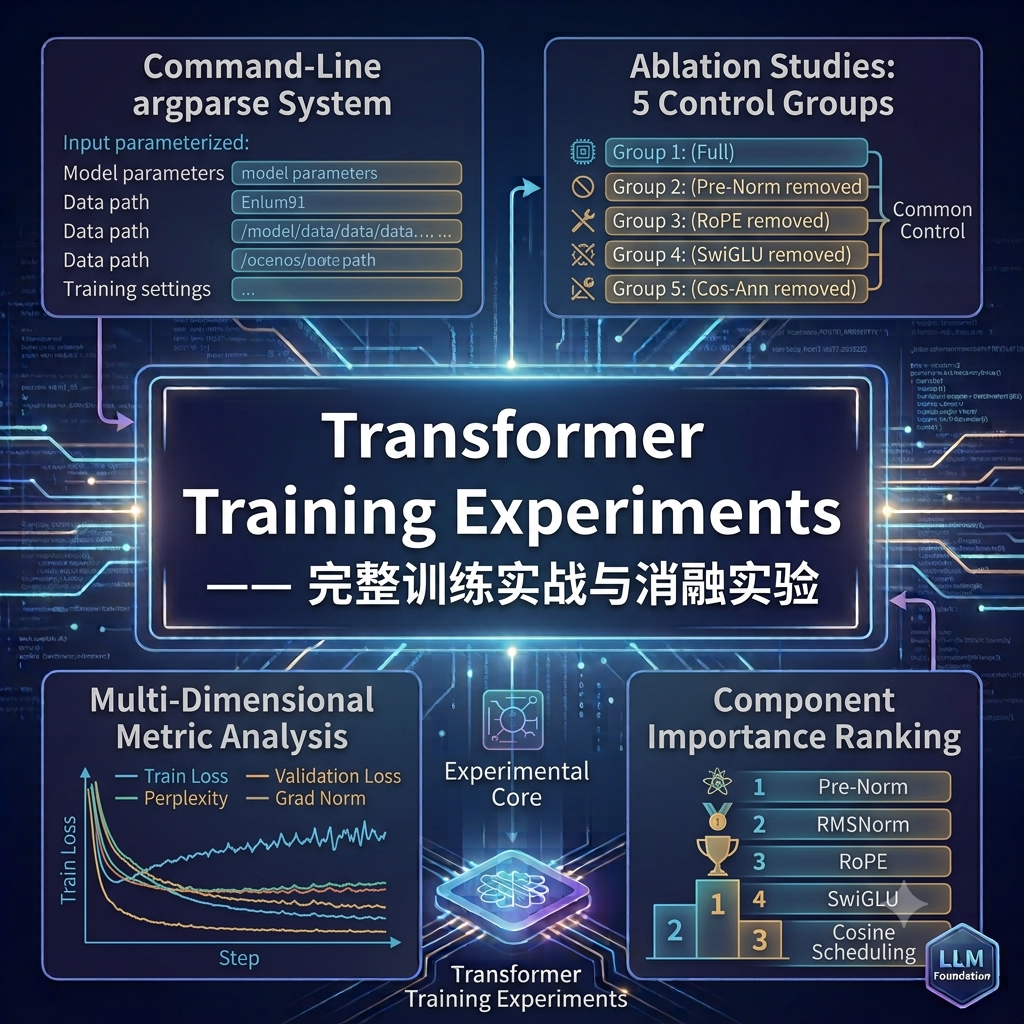
Transformer Training Experiments —— 完整训练实战与消融实验
系统讲解基于argparse的命令行训练脚本设计与五组消融实验的科学验证:从高度参数化的训练框架出发,设计五组对照实验以量化各组件贡献;基于训练损失/验证损失/困惑度/梯度范数等多维度指标分析,得出各组件重要性排序;展示完整的训练循环实现及自动化批量实验的工程价值。附有完整命令行参数体系与实验配置。
阅读文章
ZHY's Blog
A UNIVERSE OF IDEAS · BY ZHANG HAOYI
让好奇心 点亮知识宇宙
在代码、模型与思想之间自由漫游。这里持续记录人工智能、机器学习、软件工程与成长实践,让每次阅读都成为一次新的发现。


ARTICLE NOTE
经过前三篇博客的积累,我们已经完成了从分词到基础算子、再到注意力机制的全部构建工作。现在,我们可以将所有组件精妙地组合在一起,构建出一个完整的、可训练的语言模型。
如果说注意力机制是Transformer的“心脏”,那么TransformerBlock就是它的“器官”,而整个TransformerLM则是完整的“生命体”。本篇博客将展示这些组件如何协同工作,形成从输入token ID到输出logits的完整数据流。
我们将重点讨论以下几个设计维度:
vocab_size到d_ff,每个数字背后的设计考量一个标准的Transformer块由两个子层组成:
每个子层都遵循“残差连接 + 归一化”的模式。在代码中,TransformerBlock 将这两个子层封装在一起,并提供了丰富的配置选项,支持多种消融实验(如是否使用RMSNorm、是否使用RoPE、是否使用SwiGLU、归一化位置等)。
归一化的位置 —— Pre-Norm vs Post-Norm 是决定训练稳定性的关键选择,是Transformer架构设计中最关键的决策之一。
Post-Norm(原始Transformer论文中的设计):
每个子层的输出先经过残差连接,再进行归一化:
x = LayerNorm(x + Attention(x))x = LayerNorm(x + FFN(x))Pre-Norm(现代LLM的标配):
每个子层先进行归一化,再经过子层,最后与输入相加(残差连接):
x = x + Attention(LayerNorm(x))x = x + FFN(LayerNorm(x))两者在数据流上的差异看似微小,但对训练的稳定性和最终性能有着深远影响。
Pre-Norm更优的原因:
在代码中,TransformerBlock通过norm_position参数支持两种模式:
if self.norm_position == 'pre': # Pre-Norm: 先归一化,再子层,最后残差 x1 = self.norm1(in_features) x1 = self.causal_multi_head_attention(x1, token_positions) x1 = x1 + in_features
x2 = self.norm2(x1) x2 = self.ffn(x2) out = x2 + x1else: # 'post' # Post-Norm: 先子层,残差,再归一化 x1 = self.causal_multi_head_attention(in_features, token_positions) x1 = self.norm1(x1 + in_features)
x2 = self.ffn(x1) out = self.norm2(x2 + x1)残差连接(Residual Connection)是深度学习中的一项革命性发明,它通过将输入直接加到输出上,解决了深层网络中的梯度消失问题。
在Transformer块中,两个子层都使用了残差连接。数学上,Pre-Norm模式可以表示为:
残差连接允许梯度在反向传播时绕过子层的非线性变换,直接流向前层,这使得训练非常深的网络(数十层甚至上百层)成为可能。如果没有残差连接,Transformer的训练将极不稳定。
在TransformerBlock的forward中生成了**token_positions张量**:
token_positions = torch.arange(seq_len, device=in_features.device)token_positions = token_positions.unsqueeze(0).expand(batch_size, -1)这个张量传递给注意力模块(当use_rope=True时)。注意,位置信息不是作为独立的嵌入添加的,而是通过RoPE直接注入到Q和K的计算中——这正是RoPE的设计哲学。
在大规模模型训练中,我们经常需要从外部加载预训练权重——无论是为了微调(Fine-tuning)、断点续训,还是为了进行模型融合。因此,模块必须支持在初始化时通过参数传入预训练权重。
代码中的TransformerBlock和TransformerLM都设计了丰富的权重参数,允许调用者传入各个子模块的权重张量。
在TransformerBlock的__init__中接受10个权重参数 —— attn_q_proj_weight, attn_k_proj_weight, attn_v_proj_weight, attn_o_proj_weight,ln1_weight, ln2_weight,ffn_w1_weight, ffn_w2_weight, ffn_w3_weight
每个权重如果非None,则直接赋值给对应模块的weight.data。例如:
if attn_q_proj_weight is not None: self.causal_multi_head_attention.wq.weight.data = attn_q_proj_weight.data这种设计使得TransformerBlock可以独立于其父模块被初始化并加载权重,实现了模块级别的参数复用。
在TransformerLM中,我们使用一个统一的字典weights来传递所有层的预训练权重。
键名遵循层次化的命名约定,例如:"layers.0.attn.q_proj.weight"表示第0层的Q投影权重;"layers.5.ln1.weight"表示第5层的第一个归一化层权重;"token_embeddings.weight"表示词嵌入矩阵;"lm_head.weight"表示输出投影权重;"ln_final.weight"表示最终归一化权重
在初始化TransformerBlock时,从weights字典中按需提取对应层的权重:
transformer_block = TransformerBlock( # ... attn_q_proj_weight=weights.get(f"layers.{layer}.attn.q_proj.weight"), # ...)这种字典方式的好处是解耦了权重存储和模型定义——可以从任意格式的检查点文件中加载权重(如PyTorch的.pt、Hugging Face的.bin等),只要将其转换为字典格式即可。
代码中的权重加载发生在 __init__阶段,这意味着权重是在模块创建时就被赋值的。这要求外部传入的权重张量具有正确的形状(与模块定义匹配)。若形状不匹配,PyTorch会抛出异常。
在实际工程中,我们通常先构建模型(随机初始化),然后从检查点文件加载权重。代码中直接在__init__中加载是一种简化,旨在展示接口设计,实际使用中也可以采用load_state_dict的方式。
完整的Transformer语言模型由四个主要部分串联而成:
(batch, seq_len) → (batch, seq_len, d_model)d_model维映射回vocab_size维,得到logits代码中的TransformerLM正是按此结构构建的:
self.embedding_module = EmbeddingModule(vocab_size, d_model, device)
self.transformer_blocks = nn.ModuleList()for _ in range(n_layers): self.transformer_blocks.append(TransformerBlock(...))
if use_rmsnorm: self.final_norm = RMSNorm(d_model, eps=1e-5)else: self.final_norm = nn.Identity()
self.lm_head = LinearModule(d_model, vocab_size)每个超参数的取值都影响着模型的容量、速度和内存占用,这些超参数相互耦合,共同决定了模型的总参数量:
vocab_size(词表大小) —— 由分词器决定,通常为32K~100K。影响嵌入层和输出层的参数量:vocab_size × d_model × 2;词表越大,模型可表示的token越多,但嵌入层参数量也线性增加context_length(上下文长度) —— 模型能处理的最大序列长度。影响位置编码的预计算范围、注意力矩阵的复杂度();更大的上下文能捕获更长的依赖,但计算和内存开销随长度平方增长d_model(模型维度) —— 所有层中向量的基本维度,决定模型的“宽度”,直接影响参数量和计算量。典型值:GPT-2 small为768,GPT-3为12288,Llama 70B为8192n_layers(层数) —— 模型的“深度”,更多层能捕捉更抽象的特征,但层数增加会线性增加计算量和延迟n_heads(注意力头数) —— 决定多头注意力的并行子空间数。需要满足 d_model % n_heads == 0,每个头的维度 d_k = d_model / n_heads,更多的头能让模型关注更多不同的方面,但增加计算量d_ff(前馈网络隐藏维度) —— 在SwiGLU中,通常设为 (8/3) * d_model 并取整到64的倍数,以匹配标准FFN的参数量。更大的d_ff增强了FFN的表达能力,但增加了参数和计算theta(RoPE底数) —— 控制旋转频率的分布,通常取10000。较大的theta使低频旋转更慢,有利于长距离依赖神经网络的权重初始化直接决定了训练的起始状态。初始化不当可能导致:
良好的初始化应保持各层输出的方差一致,使得信号可以在网络中稳定传播。
在TransformerLM中,我们提供了一个_init_weights方法,该方法遍历所有模块,对线性层和嵌入层使用均值为0、标准差为0.02的正态分布初始化:
def _init_weights(self): for module in self.modules(): if isinstance(module, LinearModule): torch.nn.init.normal_(module.weight, mean=0.0, std=0.02) elif isinstance(module, EmbeddingModule): torch.nn.init.normal_(module.embedding_matrix, mean=0.0, std=0.02)使用0.02的标准差的原因 —— 这是GPT-2论文中采用的初始化策略,经过实验验证在中等规模模型上表现良好。对于更大的模型,可能需要更小的标准差(如0.006)配合更大的学习率。
实际上,各个基础模块已经包含了各自的初始化逻辑:
LinearModule使用截断正态分布,标准差为sqrt(2/(din+dout))(mishmash风格)EmbeddingModule使用标准差为1的截断正态分布RMSNorm初始化为全1SwiGLU中的线性层同样使用LinearModule的初始化因此,_init_weights中的通用初始化可能会覆盖这些专用初始化,这取决于调用顺序。在实际工程中,通常选择一种统一的初始化策略,并在模块定义时设置好,避免多次初始化。
输入:token ID张量 —— 假设有一个batch大小为B,序列长度为S的输入:
in_indices: torch.Tensor of shape (B, S) # 每个元素是token ID,范围 [0, vocab_size-1]Step 1: Token Embedding —— 每个token ID被替换为其对应的 d_model维嵌入向量。这一步的参数数量为 vocab_size × d_model。
x = self.embedding_module(in_indices) # (B, S) -> (B, S, d_model)Step 2: 逐层通过TransformerBlock
对于每一层 l —— x = self.transformer_blocks[l](x)
在每个TransformerBlock内部,数据流如下:
1. 子层1(多头自注意力MHA):
x_norm1 = RMSNorm(x) # (B, S, d_model)x_attn = CausalMultiHeadAttention(x_norm1) # (B, S, d_model)x = x + x_attn # 残差连接2. 子层2(前馈网络FFN):
x_norm2 = RMSNorm(x) # (B, S, d_model)x_ffn = SwiGLU(x_norm2) # (B, S, d_model)x = x + x_ffn # 残差连接整个过程中,序列长度S和模型维度d_model都保持不变。
Step 3: 最终归一化
x = self.final_norm(x) # (B, S, d_model)在Pre-Norm架构中,最后一层输出后通常还会进行一次归一化,以确保输入到LM Head的分布是稳定的。
Step 4: LM Head(输出投影)
logits = self.lm_head(x) # (B, S, d_model) -> (B, S, vocab_size)线性层将每个位置的**d_model维向量映射为vocab_size维的logits**。每个logit表示对应token的未归一化得分。
输出:logits张量 —— 最终输出logits的形状为 (B, S, vocab_size)。这个张量可以直接输入到 CrossEntropyLoss(内部会应用log_softmax)计算训练损失,或者在推理时应用 softmax 得到下一个token的概率分布。
可视化数据流
从第一篇到第四篇,我们逐步构建了一个层次化的模块体系:
BPE Tokenizer (外部工具,非PyTorch模块) ↓EmbeddingModule, LinearModule, RMSNorm, SwiGLU, RoPE (基础算子) ↓CausalMultiHeadAttention (注意力机制) ↓TransformerBlock (组合注意力 + FFN + 残差 + 归一化) ↓TransformerLM (组合嵌入 + 多层Block + 输出层)每一层都依赖于其下层,但不依赖于上层,这使得我们可以独立测试和替换任何一个模块。
代码中通过多个布尔/枚举参数支持消融实验:
use_rmsnorm:对比RMSNorm vs 无归一化norm_position:对比Pre-Norm vs Post-Normuse_rope:对比RoPE vs 无位置编码use_swiglu:对比SwiGLU vs FFNSiLU这些参数贯穿整个模型栈,从TransformerLM一路传递到各个基础模块,使得我们可以在不修改核心代码的情况下,轻松切换不同的设计选择。
与Hugging Face的GPT2Model相比,我们的实现:
当然,这些实现尚未包含一些工程优化(如Flash Attention、kv-cache等),但这些优化可以无缝集成到现有模块中。
总结本篇博客是系列中的里程碑 —— 我们将前三篇的所有组件汇聚在一起,构建了一个完整的、可训练的Transformer语言模型。重点讨论了:
- TransformerBlock:Pre-Norm vs Post-Norm的选择,残差连接的妙处,以及位置信息的传递方式
- 参数传递设计:如何通过字典方式灵活加载预训练权重,实现模块级别的参数复用
- 整体架构:四大核心组件及其超参数的设计考量,每个数字背后的权衡
- 权重初始化:从专用初始化到通用策略,确保训练起始阶段的稳定性
- 前向传播数据流:从token ID到logits的完整路径,每一步的形状变换
至此,我们已经完成了模型构建的全部工作。后续我们将进入训练环节——如何准备数据、如何计算损失、如何优化参数,最终让这个模型真正“学会”语言。
按顺序完成这组文章,循序渐进地掌握主题
发现错误、内容过时或有改进想法?欢迎告诉我
根据本文分类与标签,为你推荐可能感兴趣的内容
系统讲解基于argparse的命令行训练脚本设计与五组消融实验的科学验证:从高度参数化的训练框架出发,设计五组对照实验以量化各组件贡献;基于训练损失/验证损失/困惑度/梯度范数等多维度指标分析,得出各组件重要性排序;展示完整的训练循环实现及自动化批量实验的工程价值。附有完整命令行参数体系与实验配置。
阅读文章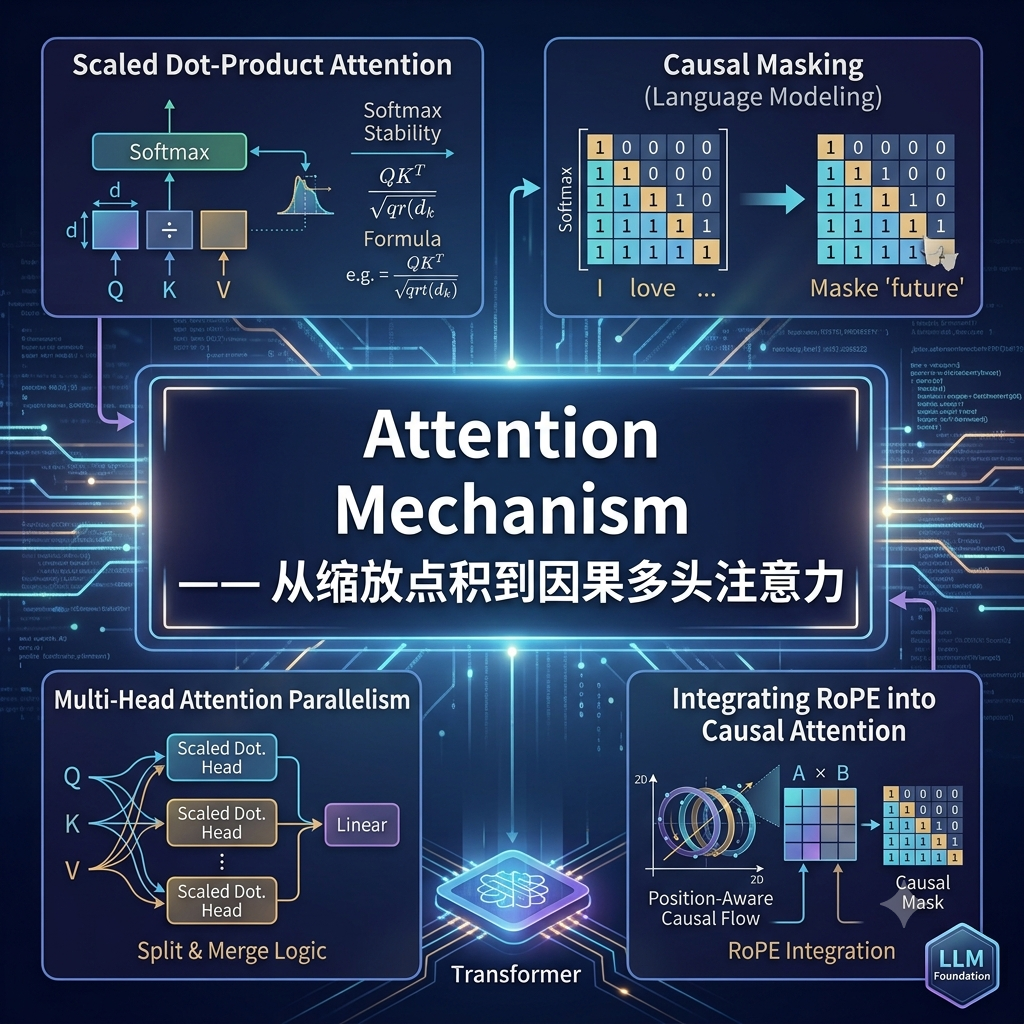
系统讲解Transformer注意力机制的核心原理与完整实现:从数值稳定的Softmax出发,推导缩放点积注意力的数学公式与几何意义;深入剖析因果掩码的下三角矩阵机制及其在自回归语言模型中的关键作用;详解多头注意力的拆分与合并逻辑及并行计算优势;最后阐述RoPE旋转位置编码如何直接融入注意力计算,与因果掩码协同实现带位置感知的因果注意力。
阅读文章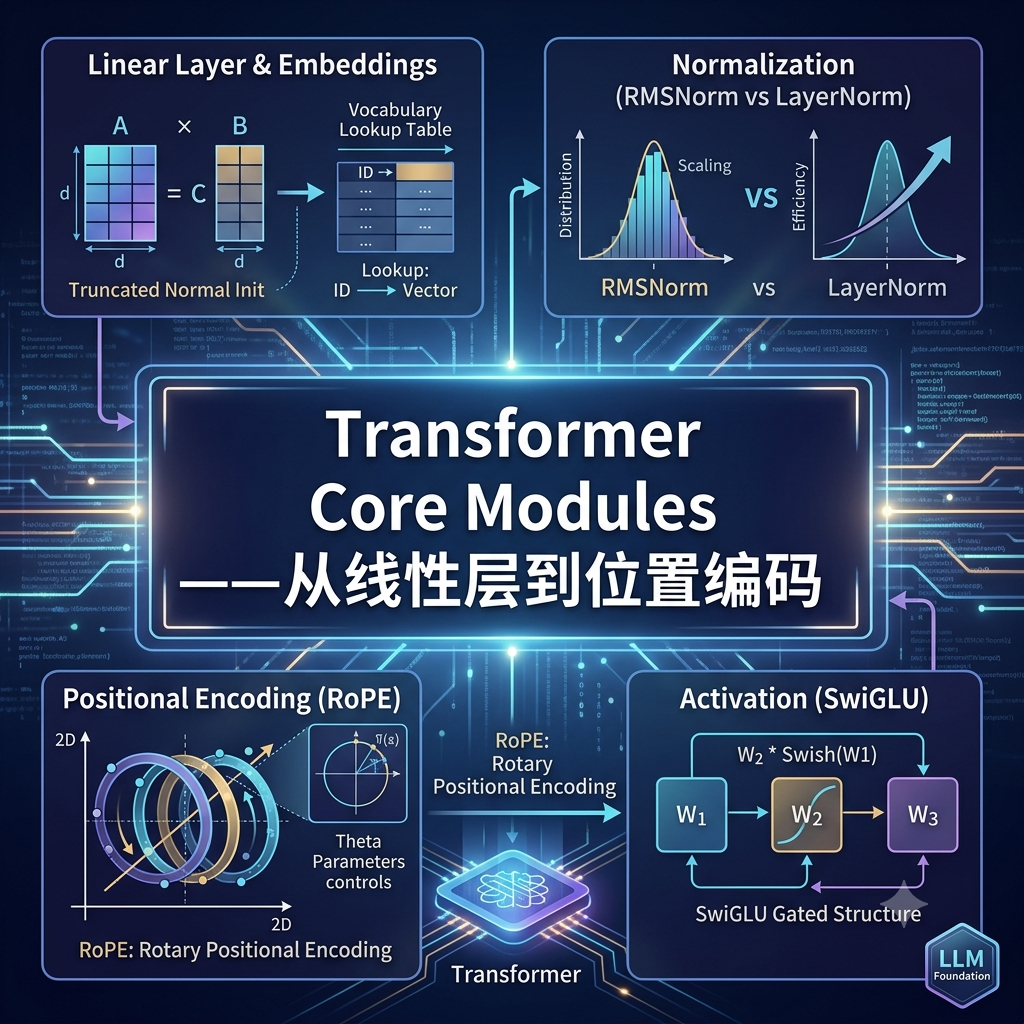
系统讲解Transformer核心模块的从零实现:从线性层的矩阵乘法本质与截断正态初始化策略出发,深入词嵌入层的查表机制与参数规模计算;推导RMSNorm相比LayerNorm的归一化原理与计算效率优势;剖析SwiGLU门控激活函数的三矩阵结构(W₁/W₂/W₃)及其参数量权衡;最后完整推导RoPE旋转位置编码的数学原理——从二维平面旋转矩阵到复数视角的高维扩展,以及theta参数对旋转频率的控制与编码质量的影响。
阅读文章请使用微信扫描二维码分享
当前文章会保持在原页面